
That's Not What I Sent
其實這是上週的事情了, 只是很忙沒空寫下來.
上週在忙的事情, 其中一件是要開始電機系網站, 教授資料部分的 Data Migration. 因為目前的網站在教師資料部分, 超過 90% 的資料比例是用 HTML 網頁方式保存的, 不是用 Database 保存資料. 加上新網站是計算機中心統一跟外面的公司購買, 資料庫系統跟格式都大不相同, 對方也沒有 Migration 的服務 ( 就算有計中應該也不會想付這錢 ), 變成要人工去做. 不過這不是重點啦~
因為資料量太多了, 而且每個教授的資料維護本來就不是我們負責的工作, 所以就乾脆提前開放教師帳號, 給每個教師的工讀學生去處理 Data Migration.
開放帳號, 當然就是要寄出帳號跟密碼啦~ 這時候就發生了此篇的重點事件, 有位同學 ( 幫某教授更新資料的, 簡單說就是新網頁系統的一般使用者之一 ) 打了分機電話過來詢問:信件裡面的密碼有一部分變成笑臉男了, 怎麼辦 ?
沒有啦, 怎麼可能真的變成笑臉男, 這樣就變成 Security 的問題了. 其實只是變成一個驚訝臉的表情符號 ( 找不到完全一樣的, 用類似的替代 ).
沒記錯的話, 該同學用的 Mail Client 是 Outlook 的樣子. 然後他不知道原來 8o 會變成表情符號, 所以也無法自行 Decode 回去 ( 其實我也不知道 @@ ), 原本的密碼應該是 8#fdt8o
這問題有趣在於,
1. 這不是因為 Security Leak 產生的問題
2. Software 沒有錯, 也提供了調整或關閉的方法
3. 收信者不知道其實他有能力讓 Software 呈現正確的訊息
4. 收信者無法自行在腦中作 Decoding
5. 寄信者在收信者沒有 Feedback 前, 完全不會知道這問題的發生. 當然, 也無法預知會有這個問題.
不知道如果從 Sender 端跟 Receiver 端分別考量這個問題, 是不是可以解決. 這樣的問題應該不只存在於 Mail System 中. 更加極端地說, 這是系統中不同 Components 之間的 Trustworthiness 問題. (下圖大小很難調, 不管了, 請將就)
在 Receiver 端要提供更加 User Friendly 的 Active Configuration Notification, 而不是倚賴 Receiver 的使用能力. 而在 Sender 端則是提供 Active Warning 的服務, 類似 Automatic Spelling Check. 不過要做到這些, 其實有許多附加的問題要解決, 不知道是否有更簡單的解決方法呢 ?
Supporting SQL in DBMS
最近因為研究上的需要, 回頭在翻一些基礎的 Database, 猛然發現很多重要的觀念, 當初唸書時都理所當然地輕帶過去, 沒有去深入思考其在軟體設計上的意義.
例如昨天忽然就想到 SQL 在不同 DBMS 上的問題. 當然我知道 SQL/ANSI-SQL 已經算是 RDBMS 領域的標準語言, 但是, 是否各家 RDBMS 需要自己實做對於 SQL 的所有支援, 或是有某幾種 SQL 處理引擎或元件是可以直接被不同的 RDBMS 採用的 ?
修過 Database 基礎課程以及 Database Tuning 課程, 卻沒有想過這個問題...
回頭翻了手上的 Database System Concept 帆船本第四版, 在介紹 SQL 時完全是以使用以及對比前一章的 Data Definition Language 角度來寫, 自然沒有提到 Database Architecture 的事情. 其他地方我也沒翻到, 直到最後面的 Case Studies 在 SQL Server 的部份才略為說到一點 Query Processing 的東西. D. Shasha et al. 的 Database Tuning 則是在第四章一開始, 以及第五章一開始有提到, 特別是 ODBC 的部份, 不過顯然我當初這地方是很直覺地帶過去了 = =
對照網路上找得到的 SQL Server Architecture 參考圖 ( from http://sqlbaba.wordpress.com/ )
再來個 MySQL 5.5 的架構圖
答案我想應該就跟很符合邏輯的猜測一樣, 在效能調校及商業機密考量下, 主要的 Vendors 應該都還是自行實做 SQL 處理的部份.
音樂情緒研究問卷
偶然看到台大電信所的研究生在 PTT 徵求進行音樂情緒問卷, 因為對 yihsuan ( Perosnal Blog, 但是很少更新) 這個名字有點印象(後來發現他是 [1] 的首位作者, 之前實驗室有同仁報過這篇 paper, 難怪有點印象), 加上之前實驗室也有同仁在做音樂情緒相關研究, 就特意點進去看看.
問卷網站有點慢, 同時是 IE Only, 我還特地開 Virtual Box 來連 = =
問卷分成幾個大部分, 首先是 Introduction 進行一般音樂情緒說明,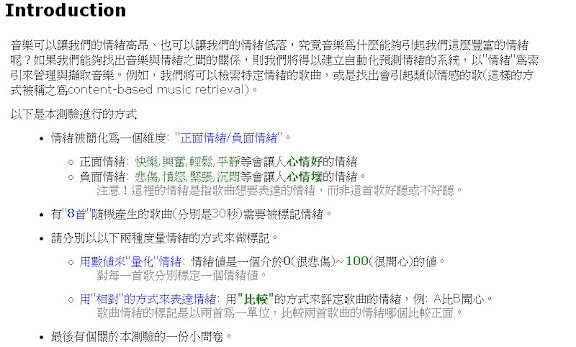
不太確定分類是如何決定的, 但是根據之前聽過數次同仁的 presentation, 猜想應該跟 R. E. Thayer 的 AV Emotion Plane [2] 有相關.
第一階段是直接用聽的請 Visitor 給分數, 很單純的從悲傷到開心的分數. 至於分數怎樣對應到 AV Emotion Plane 就不知道了.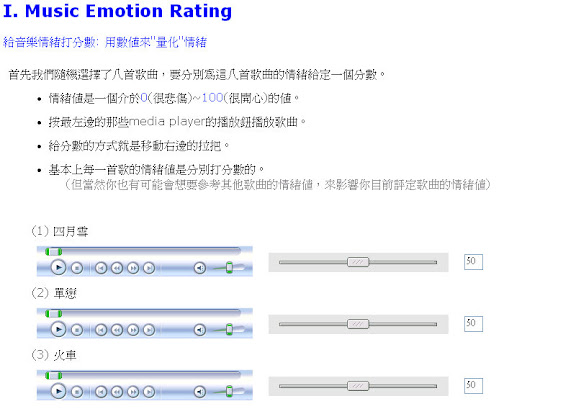
第二階段使用了一個 Tournament 來讓使用者從不同音樂的比較中給予相對的情緒關係分數 ( 比對本身可以算是一種分數 ).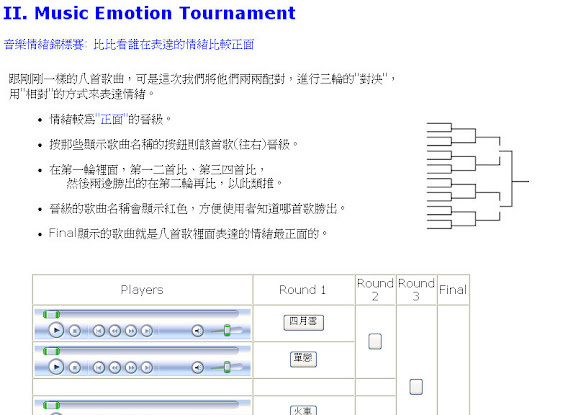
這個手法感覺比較有意思, 跟 男女糾察隊 London Hearts 的節目中使用的 臉蛋好壞球 (顔面どストライク) 很像, 之前在看 Paper [1] 時我也有想過把 臉蛋好壞球 搬到 Music 領域來玩玩看 :p
底下來個上戶彩的作參考 (取用自這裡 -- Orz 有沒有這麼巧, 隨便找一下連到的居然是緯來當家美女主播的 Vlog ) :
最後一個階段則是對於使用者標示音樂情緒的一般性調查, 不過我覺得裡面出乎我意料地缺少相當多對於使用者 Context 的調查, 換句話說上面的音樂情緒標定是無法根據使用者的個人背景以及目前的情緒, 環境工作等等作進一步解析的. 這對 Data 的 Reliability 我認為是一種傷害, 特別是 Music Emotion 這種在判定時會受到相當多 Factors 影響的東西.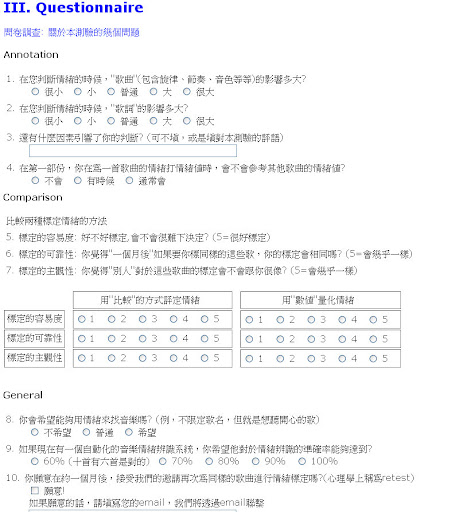
其實我對於音樂情緒一直不太相信, 最主要的原因即在於 Emotion 這種東西的判定 Variation 太大, 而音樂的創作又跟相當多的 Factors 有關, 有時候創作者是因為環境, 有時候是因為故事, 有時候是因為其他的音樂, 不確定加上不確定實在沒辦法讓我相信會變成一個確定. 而 Emotion 的 Variation 太大也導致多數的 Researches 都停留在諸如 Kate Hevner [4] 的八個分類, 或是 [1] 使用的 AV Emotion Plane 上, 但是這麼粗的分類感覺實在不實用.
另外就是音樂情緒的應用, 實驗室的學弟做的 [3] 是跟 Music Therapy 有關, 在 Therapy 上音樂可能有用這個我就相信, 但是很多 Papers 都會提到利用音樂情緒對於大量的音樂作自動分類判定 -- OK, 我相信可以自動分類, 但是為什麼我們要自動利用音樂情緒分類大量音樂 ? 到底誰會是使用者, 誰需要對於大量音樂進行音樂情緒的自動分類 ? 這個問題我一直想不透阿, 也許這也跟我本身有關, 我會留著的音樂大多是自己聽過喜歡的, 但是卻不會刻意去區分所謂的音樂情緒.
我想, 如果同樣的問卷是詢問使用該音樂的情境, 應該會比較有用吧, 很多時候我們想找音樂是希望配合目前的 Context 來用, 雖然說也可以透過情緒的轉換去作 Matching, 但是為什麼要如此麻煩呢 ?
P.S. 在閱讀 [1] 時我覺得其實內容很 Tricky, 主要是在 Data Collection 的地方做了大量的 Assumptions, 這讓我很不舒服 (Feel Uncomfortable), 另外歌詞的影響也被計量在內, 作為 Music 的一部分, 雖然說得通, 但是就讓我很不舒服, 對於我個人來說, 當你聽的懂歌詞時, 往往歌詞的影響力跟 Music 本身會不相上下, 這樣一來究竟你是在辨認 Music Emotion 或是 Lyric Emotion 就很難說了.
References
[1] Y.-H. Yang, Y.-C. Lin, Y.-F Su, and H.-H. Chen, “A Regression Approach to Music Emotion Recognition,” IEEE Transactions on Audio, Speech, and Language Processing, vol. 16, no. 2, pp. 448-457, Feb. 2008.
[2] R. E. Thayer, The Biopsychology of Mood and Arousal, New York Oxford University Press, 1989
[3] Yin-Kai Wu, Discovering Musical Features for Automatic Emotion Classification in Music Therapy, Master Dissertation, NCKU, 2008
[4] Kate Hevner, Experimental Studies of the Elements of Expression in Music, American Journal of Psychology, Vol. 48, pp. 246-268.
Manage Correlated Data Across Services ?
利用不同的 Services 來存放不同的 Data, 然後在一個統一的 Blog 展示是目前 BSP 系統的標準設計模式. 然而 BSP 對於整體 Data 的管理策略可能還有值得討論的地方.
以無名的例子來說, 進行 Blogging 的使用者可能同時利用他的網路相簿跟網路影音服務, 但基本上該兩項服務的 Data 跟 Blog 本身是分開的, 只是在 Blog 上提供可以存取該 Data 的介面. 有時候使用者如果因為特殊原因要暫時關閉該 Blog, 原則上相關的 Data 應該也無法取得才對.
例如無名的 tiger302 這個 Blog, 因為某些理由被使用者關閉, 因此相關的相簿影音等資料也無法取得. 但是如果你從 無名影音 進行搜尋的話, 事實上還是找的到相關的 Index, 只是連結進去後一樣是無法讀取.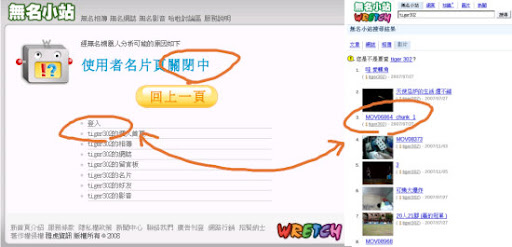
然而, 雖然無法透過尋常的 Blog 或是搜尋介面看到影片資料, 如果有心人在 Blog 開放時留下影片連結的話, 居然是可以直接看到理應被禁止存取的影片 Data, 例如同樣是 tiger302 上傳的這隻影片 :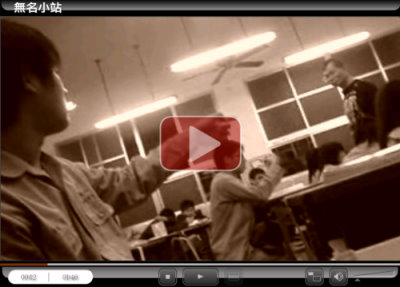
顯然地, 無名是利用禁止某些 Service 被執行, 來達到禁止 Data 被取得, 但是這樣作就會產生上面的這種漏網之魚 -- 也就是某些公開的 Service 還是可以取得該資料.
同樣的情況在其他的 BSP 上也可能出現, 如果 BSP 沒辦法讓使用者把相關的資料都綁在一起作管理的話, 就可能出現文章被禁止存取了, 圖片跟相關影片卻還是可以被取得的情況. 然而, 以使用者的角度來說, 文章就包含了圖片跟影片, 而非只有文字而已. 因此相關 Data 都應該被禁止存取.
在無名的例子中對於此問題還算好解決, 只要 BSP 願意多花點心思調整一下 Data Model 或是 Access Model, 提供給使用者在發表文章時作選擇即可. 然而當這個問題是跨服務 (Across Services) 時就會複雜許多.
在幾年前的台灣 BBS 也存在類似的問題. 當時全台灣大大小小的 BBS 可能有上千個, 透過 Mailing List 原本的機制, 彼此轉信變成一種風潮. 但是轉信的看板之間卻出現一種問題, 當有使用者錯發文章, 或是不恰當的文章要被刪除時, 只有原本的發信站做了刪除, 其他收信站還需要該站或看板的管理者再做一次判斷. 造成垃圾文章需要花費大量的人力管理刪除. 後來的 BBS 發展出 control.cancel 協定, 只要支援該協定, 可以透過轉信機制自動刪除在發信站已被刪除的垃圾文章.
但這要在不同的 Services 之間, 支援共同的 Protocol 似乎難度大的許多, 況且允許的動作也不是簡單的刪除而已.
Bookmark Mindmap
前幾天在 RWW 上有一篇文章, 介紹了可以幫助 Bookmark Favorite Images 的三個 Sites : 3 Cool Sites to Bookmark Your Favorite Images on the Web. 昨天在看到一篇與 Cloud Computing 相關的文章, 並把他利用回應的方式附加到我之前的文章時, 忽然想到, 往往我們在 Web 上會看到跟之前一些想法相關的資料, 包含文章圖片影像動畫等等 -- 姑且稱為 Web Materials 好了 -- 是否可以有很容易的方法來蒐集組織他們呢 ? 之前用過 Google Notebook, 在蒐集上是很方便, 但是後端的組織就比較弱. 這種類似的系統由於缺乏比較系統化的組織工具, 因此容易出現蒐集了一堆, 後續處理反而麻煩的情況.
如果我們把自己的 Blog 視為表達紀錄自己知識的媒介, 那麼其實可以把這種組織的行為以 Blog 文章為中心作連結, 等同於以 "Adding" 的方式連結別人的知識到自己的知識上, 同時這是屬於個人式的知識累積. 很直覺的會想到利用 MindMap 來作整理. 借用 FreeMind 作個假想圖 :
利用 "Bookmark MindMap" 在 Google 做了一下搜尋, 發現有一些類似的 Tools, 例如有人替 Del.icio.us 作了 Delicious Mind Map Maker, 可以吃進你的 Del.icio.us 資料, 製作出 MindMap 來.
另外 DeliciousMind 也同樣是幫助把 Del.icio.us 上的資料以 MindMap 形式作整理與呈現的工具, 他利用了 FeeeMind. ( 這裡有額外的介紹跟 Examples )
不過這些都跟我想要的還是有一段距離. 我認為一張 MindMap 應該是以一篇 Post 為中心, 而往外擴展關係, 然而整個網站未必要是多張獨立的 MindMap, 這樣會讓 Blogger 整理到死. 相對的, 一個 Blog 本身是 Personal Knowledge Web, 而以單一 Post 為中心可以得到一個以上的 MindMaps. 這也跟之前 Library 2.0 的討論有相關之處.
Something about Library 2.0 (1) : Digital Library
Library 2.0 的議題在國內外已經有數年的討論了. 關於命名當然跟 Web 2.0 有關, 但是整體概念的演進早在 Web 2.0 被 Tim O'Reilly 拋出之前.
我現在有在訂閱的幾個 Bloggers 也持續的關注此議題, 不過大多是以圖書館員, 或是圖書館界人士的角度. 正巧我之前跟老師的討論中整理了一些關於 Library 的想法, 是從 Architecture Evolution 的角度整理的, 順手搬到 Blog 上, 從不同的角度看 Library 2.0
跟其他的 XXX 2.0 一樣, Library 2.0 絕對不是獨立的技術跟概念, 而是同一個趨勢在不同領域的展現, 透過搬移其他領域的成功經驗, 以及解決其他領域一樣遇到的問題, 才有可能讓 Library 2.0 的理想獲得成功. ( 當然, 還要主事者不腦殘 = = )
1. The Definition
引用 Wikipedia 上對於 Library 的部分敘述 :
A library is a collection of information, sources, resources and services, organized for use, and maintained by a public body, an institution, or a private individual. In the more traditional sense, it means a collection of books. This collection and services are used by people who choose not to — or cannot afford to — purchase an extensive collection themselves, who need material no individual can reasonably be expected to have, or who require professional assistance with their research.
從這段敘述中可以推想出幾個關於 Library 的特性, 我認為也適用於 Library 2.0 :
- Library 內的東西可以有很多種, 而非只有 book 而已
- Library 內的東西必須經過特定的整理以方便使用
- Library 的 maintainer 可以是單一個人, 一小團體, 一個機構, 甚至是大眾, 並沒有特別限制
- Library 的大小並沒有特別的限制
- Library 的使用者數量也沒有特別的限制
2. The Conventional Solution
目前常見的 Library 所採取的做法是, 由 Maintainer Role 負責為 Library 內的各種 contents, 例如 books, 事先以特定的分類方式作分類, 然後 User Role 必需去學習這樣的分類方式, 以便有效率地進行搜尋以取得想要的 contents.
在此做法下, Maintainer Role, Library, 以及 User Role 之間的關係像是這樣的 :
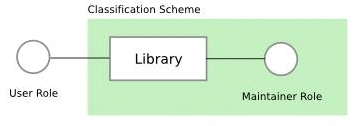
Maintainer Role 除了要負責維持 Library 的 functionality 運作之外, 同時也負責設計及實施 classification scheme, 而 User Role 是在 Maintainer Role 所決定的 Classification Scheme 下所使用 Library.
這樣的 solution 基本上是可以運作並實現 Library 的功能, 但是這樣的 solution 並不夠好 :
在此 solution 底下, User Role 被迫必須接受並使用 Maintainer Role 的觀點, 而難以較有效率且符合自身需要的方式來重新分類 Library 內的 contents
對 Maintainer Role 來說, 也因為此 solution 而限制了他們可以嘗試的 classification scheme. 因為大多數 Users 會希望到各個不同 Library 可以以自己習慣的方式作 contents 找尋的動作, 而不是每到不同的 Library 就需要面對不同的 classification scheme. 因此 Maintainer Role 其實只能被限制在數種主流的 classification scheme 中
我認為之所以會產生這些 imperfect 問題的原因, 其實跟過去基於人力所能負擔的 effort 有限, 以及 Library 是實體的 ( Physical ) 有關, 例如圖書館.
由於過去主要以人力進行管理與維護, 因此如果 classification scheme 不由 Maintainer Role 所掌控, 並強迫 User Role 依照統一的 scheme 使用, 則為了應付不同 Users 的需求, Library Maintainer 必須花費相當巨量的 efforts 來提供服務, 但如此一來 cost 也相對大量增加, 這將與 Library 概念的初衷之一, 減少整體社會接觸知識所需要的 cost, 產生相違背的情況.
3. The Digital Solution
在 Computer 被發明並普及化後, 其實我們應該回頭去思考, 是否可以利用 computer 的 computation power, 重新去改進過去限於人力考量, 所無法圓滿解決的 Library 問題.
利用 computer 的特點在於, (1) computer 具有較為低廉的 computation power, (2) 基於 computer, 許多 Library contents 得以數位化 ( digital ) 的形式存在, 以及被取用. 底下稱呼利用 computer 來解決的做法為 digital solution.
鑑於 application context 的不同, 我認為 digital solution 可以分為下面兩者, 兩者的差別在於 Library 內所管理的 contents 是否具有實體而定.
Semi-Digital Library : 其內的 contents 仍然具有實體, 因此我們不可能使用不固定的 classification scheme 來管理這些 contents, 在實體世界中必然要選擇一種 scheme 來管理這些實體 contents. 但是對於 User Role 在進行搜尋來說, 由於可以把這些實體 contents 以虛擬的物件 ( Virtual Object ) 來表示, 因此在 User Role 端可以保有自己的classification scheme, 透過 computer 進行管理, 不需要花費 Maintainer Role 的 effort. 因此在此 solution 下, Maintainer Role 的責任略小, 只負責實體 contents 的管理, 以及 Semi-Digital Library functionality 的正常運作.

Digital Library : 其內的 contents 完全是 digital contents, 因此完全可以使用 computer 進行儲存以及其他管理. 因此在 classification 部分, Maintainer Role 完全不需要介入, Maintainer Role 將只需要負擔維持 Digital Library 的 functionality 正常運作的責任即可. 而 classification scheme 將完全基於 User Role 運作.
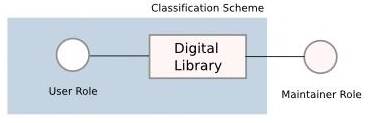
上述的 Semi-Digital Library 以及 Digital Library 兩個 solutions 之共同特點在於, 利用 computer, 將 classification scheme 的調整以及決定, 曝露 ( expose ) 給 User Role. 進而 classification scheme 有機會具備 personalization 的特性. 而回頭去看 conventional solution 中的 imperfect 部分, 將可以藉由此種方式被滿足.
4. Personal Small Library
另外在此想特別針對較小的 Library 討論其應用 digital solution 之後的改變.
在 1999 年日本偶像劇場有一部戲劇叫做 Lipstick, 其內有一句台詞大概是這樣說 :
許多小型的 Libraries 事實上具有特殊的用途, 可能是學者或是作家私人的參考資料庫, 或是一個實驗室共用的圖書研究資料蒐藏, 一個機構的歷史文件彙整等等. 因此裡面所放置的 contents相當程度反映了 Maintainer Role 或是 User Role groups 的相關訊息, 極有可能這些 contents 本身就具有一定的相關度, 而此相關度反映在使用該 Library 的 users 身上. 同時這樣的小型圖書館有一個極大的特點, 在於 User Role 的使用方式以及用途有極高的相似度, 使得嘗試統整所有使用者的 classification scheme, 以及 logic, 來為彼此的搜尋提供幫助, 具有很高的可行性以及實用性.
如果有一個夠小的公共圖書館, 是由一個人單獨維護管理 ( 包含選書以及整理 ), 則透過仔細觀察這個圖書館裡的書, 你將能夠窺視管理者的個人思維.
然而這在 conventional solution 中較難以實現, 理由是各 Users 的使用觀點事實上會隨著時間而有所變動, 進而牽動整個 group 的整體共通觀點改變, 換句話說這樣的改變是動態地, 隨時發生的, 且是藉由許多 Users 的意見交錯協調條而達到一個穩定的狀態 ( Stable Status). 在 conventional solution 中, 這樣的改變較難以達到, 因為這需要所有 Users 定期舉行會議, 討論大家都可以接受的 classification scheme, 相當地耗費時間.
相對來說, 在 digital solution 中顯然就較為容易做到, 藉由 computer 以及 network 的幫助, Users 的使用模式以及使用邏輯 ( Logic ) 可以被紀錄與分析, 進而彼此影響, 達到一個 group 內共享的觀點. 而且此共享的觀點可以隨著 Users 端的改變而動態地調整. 而在此同時, 各 Users 保持有自己的觀點仍舊是可能的.
而由此觀點而言, Semi-Digital Library 以及 Digital Library 使得 Library 不再只是靜態的 content data 的分類存放以及取用場所, 而是轉變為 group 內 users 的意見彙整平台之一, 透過在 Digital Library 內分享觀點, Digital Library 轉變成為引導 group 前進方向的動態角色之一.
5. Public Large Library
Large Public Library 的情況就與 Small Library 的情況不盡相同. 差異在於 Large Public Library 的使用者通常較多且雜, 使用目的也差異較大, 因此利用 digital solution 可以達到的好處應該會比較偏向 personalization 部分. 然而在統計數據的支持下, 或許可以考慮把 Large Public Library 切割成數個 clusters, 然後將每個 cluster 視為 Small Library 來處理. 在此情況下, 需要每個 cluster 有固定的 Users 才可行.
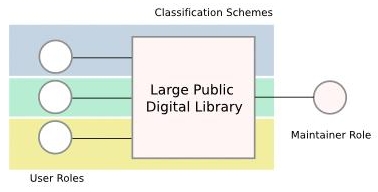
目前在 Web Recommendation System 上已經出現了類似的概念被實現, 例如 Reddit, Mixx 都有讓使用者建立自己的 Community 的能力, 而 Digg 也準備跟進. 當然這只是在 Web 的部份而已.
Beyond Single-Page Web Search Results, and ... What's The Next ? Community Page Ranking ?
本週實驗室會議由學長報告了 [1] 這篇 Paper. 其實之前我旁聽實驗室另外一個 Project 的進度會議時就已經大略看過這篇了, 不過本週趁機重新看一次, 反而有些新的想法 -- 可見得有些 Paper 時不時要多看幾次.
這篇 Paper 的基本概念很簡單, 解決的問題很小 ( 或者該說精準 ) 但很實在.
目前的 Web Search Engine 基本上是以 Single Web Page 作為單位進行關鍵字比對, 然後把符合或部份符合的 Pages 傳回, 通常會依照符合的程度進行排序 (Ranking). 不同的 Search Engine 可能會有額外的 Ranking Factors, 像是 Google 有自己著名的 Page Ranking 演算法, 另外考量商業廣告因素, 關鍵字出現頻率等等, 可以對於排序演算法再做調整.
但不管怎樣作排序跟 Page Ranking, 以 Single Web Page 為單位就會出現, 用了多重關鍵字進行搜尋, 但是沒有任何一個 Page 完全符合關鍵字組的情況. 使用者必須由列出的 Pages 之中, 瀏覽排前面數名的 Pages, 才有可能得到真正想要的資訊. 這大致符合我們的使用經驗.
Paper [1] 的想法則是, 把原本 Single Web Page 的情況, 進步到 Multiple Web Pages -- 既然我們本來就會需要瀏覽多個 Pages 來得到我們想要的東西, 為什麼不在 Search 時就直接給我 Multiple Pages 的比對結果呢 ?
( 下圖修改組合自 [1] 內容的截圖 )
因此 Paper [1] 把 Multiple Pages 結合起來成為一個 Composed Page 作為搜尋結果. 但是 Multiple Pages 也不能亂選, 否則可能造成內容事實上差距很大, 不相干的東西被包裝在一起, 因此考量了 Pages 之間應該會有 Hyperlink 的關係. 同時 Composed Page 內也要避免因為 Pages 太多不好快速瀏覽, 因此針對一個 Page, 也提供了 Query-Specific Summarize 的演算法, 藉由把一個 Page 的文字內容作切段, 以 Query 用的關鍵字組為依據, 利用 Text Information Retrieval 的方法, 以及 LSI 技術, 建立一個 Page Graph, 然後計算出具代表性的部份作為 Summary. 而多個 Pages 在 Summarize 過後進一步把 Summary 結合成為 Composed Page. 詳細的演算法在 [1] 中有說明.
從 User Query 的觀點來說, Paper [1] 注意到越來越多使用者傾向使用關鍵字組作為 Search Context 的 Abstraction, 並期望找到的資訊可以填到 Search Context 中. 而過去 Single Web Page 的作法使得使用者要自己負責彙整 Single Web Pages, 透過 Hyperlink 去找尋 ( Explore ) 更廣的資料, 然後歸納出一個有用的 Page Set 出來. 而此篇 Paper 稍微前進了一步, 在可以幫忙進行事前整理的範圍內, 先把相關的 Pages ( 可能橫跨 Websites ) 做了整理, 同時以 Summarize 過後的內容結合成一個 Composed Page, 來逼近 User 的 Search Context.
從 Single Web Page Ranking 到 Multiple Web Page Ranking ( Summarized, Composed Page ), 下一個階段會是甚麼呢 ?
Community Page Ranking 或許有機會. 不管是 Single Web Page Ranking 或是 Multiple Web Page Ranking, 基本上如果你輸入的是一樣的關鍵字組, 結果應該是一樣的, 換句話說對於所有使用者來說是一視同仁的. 這也是因為我們無法事先預測可能的使用情況 ( Search Context ), 因此只好這樣作. 但是如果可以鎖定一個 Community, 透過 Community Member 就可能定義出屬於該 Community 的可預測 Search Contexts, 這時候要更進一步對於 Pages 作事前組織就是有可能的事情. 同樣的 Pages Set 在 Travel Community 與 Local City Community, 使用同樣的關鍵字組, 可能會是得到不一樣的 Composed Page.
感覺 Google 已經開始透過 Knol 希望逐漸建立可信賴的 Knowledge Group 了, 或許將來與 Community 在 Knowledge Search 方面會有更加深入的互動.
References
[1] R. Varadarajan, V. Hristidis, and Tao Li, "Beyond Single-Page Web Search Results," IEEE Transactions on Knowledge and Data Engineering, vol.20, no.3, pp.411 - 424, March 2008
Twitter + Google Maps Should Go Beyond TwitterVision
Google Maps 現在也加上 Walking Direction 的資訊了( RWW 也有相關文章 ), 這基本上是一個必然的動作, 能夠讓地圖提供更有效率的幫助. 即便是在有了各種電子地圖後, 查閱地理資訊變得更加容易, 自動規劃路程也變得可能, 然而缺乏更加詳細的資訊卻讓許多理想的服務無法完成. 像是 UrMap 也遲遲未能提供台北縣市以外的大眾交通工具資訊, 以及路線規劃只能提供汽車, 沒辦法照顧到機車族群. 我認為問題不在於 Algorithm 的設計以及 Computation Power 的限制, 而在於 Valid Data 的取得.
透過 Sensor 或是 GPS Devices 固然是一種方式, 也常用於自然災害偵測與防治以及疾病控管等大範圍監控系統上, 但是幾乎都是透過衛星傳輸資料, 要在城市中使用, 為了降低成本需要仰賴於城市無線網路基礎設施, 同時即便如此, 大量的 Sensor 裝設費用仍然很嚇人.
在這些困難下, 其實過去的警廣交通網作法, 反而是可以讓人考慮的一條路. 台灣主要道路的路況是由熱心的駕駛回報到警廣, 然後由警廣彙整略加查核後由廣播通知鄰近其他駕駛人
同樣地, 我們可以期待類似 Twitter 與 Google Maps 的結合. 透過 Twitter, 使用者可以時不時地簡短報告自己周圍的地理狀況, 然後以 Google Maps 作為具體呈現的平台, 廣播給大家知道. 已經有類似的服務在 TwitterVision 被實現. 相關的主題也可以在 Google 上利用 "Twitter Google Maps Mashup" 作為關鍵字找尋, 有相當多的討論.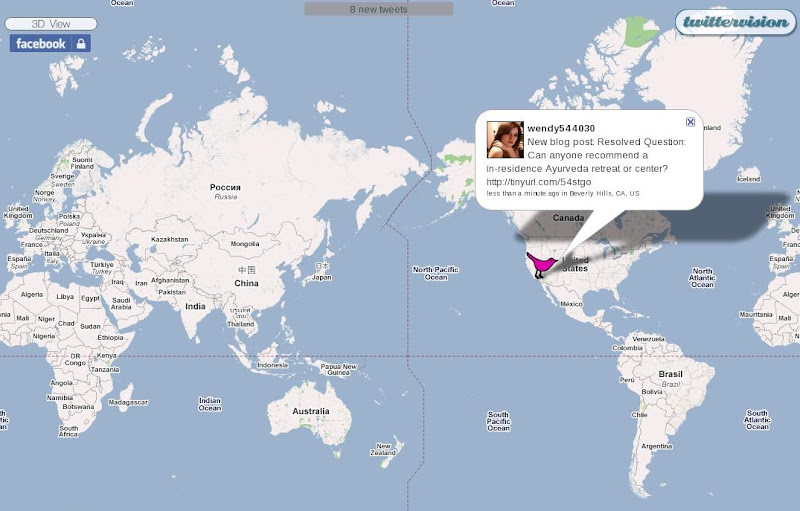 然而 TwitterVision 也只是讓 Twitter + Google Maps 發揮 1 + 1 = 2 的效果而已, 我們需要讓 1 + 1 > 2 .
透過 Twitter 而來的 Message 或是 Media (Photo, Vedio Clip, etc) 應該可以在使用者輸入時先作簡單的分類或是 Tagging, 然後在後端利用 Semantic Analysis & Semantic Web 以及 Image Recognition, Image Classification 對於這些資料根據 Google Maps 的基本地理條件 (Constraints) 作彙整, 針對不同使用者的使用需求, 提供即時的相關資料整理.
交通以及路況就是一個很容易處理的應用. 只要在輸入者提供一些簡單的 Template, 很容易就能得到使用者身邊有用的 Data, 然後就能夠整理成該地區有用的交通及路況資訊. 當然, 這依舊仰賴於無線網路基礎設施的鋪設, 以及手持式電子裝置的普及 -- 不過話說回來, 這時代有哪項網路服務不是建立在這樣的預想 (Assumption) 之下 ?
期待很快能看到這樣的 Product 出現 :)
Realtime Mining Applied
上學期修課跟學弟合作的一個期末計畫是建立一個巴士系統的 Embedded Middleware. 目前這東西也慢慢延伸變成學弟的 Master Research. 在整個 Vision 中, 有一部分就是關連到即時地蒐集巴士系統中 Customer 相關的資訊, 以及整理分析這些資訊, 產生出足以作為決策支援的資訊 ( Structured Information ).
類似的東西已經開始有人用 GPS 得到的資料做出 Prototype 來摟.
6/22 的 NY Times 報導了此一 Prototype : Predicting Where You’ll Go and What You’ll Like , 由 Sense Networks 這家公司開發 ( 我覺得他們名字取得不錯 ) . 基本概念是利用 GPS 得到 Location Data 以及 Movement Data, 然後透過適當的 Mining Algorithm 分析, 就可能得到關於行為模式的猜測結論. 在文章中期時也提到, 可以用來被追蹤 (Track) 的東西很多, 不見得只有 Location 可以用來追蹤猜測人們的行為. ( 以下圖片引用自 Sense Network Media Center 公開資料, 上面還有 Vedio 可以下載 )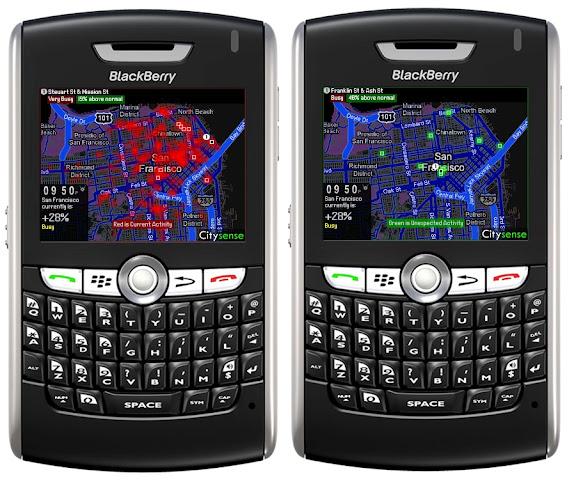
Realtime Data Mining 技術本身其實不是困難點, 困難的是怎樣讓整個 Process 可以真正應用到商業行為中使用. 期間需要考量的, 整合各種軟硬體設施, 同時城市無線網路的基礎也不可或缺. 另外就是使用者願意曝露自身資料的意願.
不過從過去的成功經驗來看, 其實這個世界的人們對於自身的資料隱私其實不是真的那麼在意 -- 只要有利可圖的話.
Sense Network 做出了很合理且聰明的決定, 他們不是一廂情願的向使用者買 Data 或是期望使用者會自動主動提供資料. 而是利用提供給使用者相關服務來換取資料 ( 原文為 : Sense decided to trade services for data. ) 而 Sense Network 自然可以從操作廣告以及服務之間得到適當的利益. 從 Google 以來, 這似乎已經是 Web 2.0 唯一具有足夠商業成功案例的模式了.
但是 Sense Network 是否能夠獲得足夠久的成功卻還很難說, 相當仰賴於他們的商業操作手段. 使用者的 Location 資料並非是會有長久價值的資料, 其 Lifecycle 可能只有短短的數個小時, 因此 Sense Network 不可能像是某些 Blog Supplier 一樣透過累積大量的懶惰使用者讓自己不倒, 而就算是在 使用者 <-> 手持裝置 <-> 位置及其他資料 <-> 可得服務 的 Cycle 中, Sense Network 也不是居在任何不可取代的位置. 因此一切都還很難說.
唯一能肯定的是 Realtime Mining 相關應用的這個趨勢應該確實會發生.
BASE : An ACID Alternative
上個月的 ACM Queue 趕在最後幾天刊出了 Dan Pritchett, Technical Fellow at eBay, 的一篇文章 : BASE: An ACID Alternative.
BASE ( Basically Available, Soft State, and Eventually Consistent ) 相對於傳統的 ACID 以強調 Consistency 為主, 改為採用犧牲 Consistency 來換取 Availability 的概念.
基本上 Consistency 跟 Availability 常常是唱反調的, 因為要確保 Consistency 免不了需要在每個動作之前進行妥協 ( Negotiation ) 或是動作之後的檢查, 例如經典的 Two Phase Commit ( 2PC ), 而這就會傷害到 Availability. 在 BASE 的方法中, 把 Consistency 的檢查做了延遲, 先允許部份動作的進行與 Commit, 等所有的動作完成之後再設法確認無誤.
在文章中舉了一個例子 : 在 eBay 上有兩個角色, Seller 以及 Buyer. 當 Seller 把商品賣給 Buyer 之後, 首先要更新交易紀錄表, 再來兩邊的 Account 資訊都要進行更新 ( Schema Design 請參考文章 ). 在傳統 ACID 的角度上來說, 通常這些動作會收集在同一個 Transaction 內部, 只進行一次 Commit, 確保兩邊 (交易紀錄表以及使用者紀錄表) 的 Consistency. (以下範例及圖片引用自 [1] )
而 BASE 的作法則是, 把交易紀錄表的更新與使用者紀錄表的更新分開, 變成數個 Transactions. 首先進行交易紀錄表的更新 Master Transaction, 然後再執行兩個更新使用者紀錄表的 Sub Transactions ( Seller 以及 Buyer ). 在 Master Transaction 中除了更新交易紀錄表之外, 事實上還發出了進行接下來數個 Sub Transactions 的要求到一個 Message Queue 中, 然後進行 Commit. 而在 Message Queue 中的 SQL Statement 則會在之後個別以 Transactions 作包裝進行 Commit. 基本概念大略是這樣, 文章後半段還有討論到 Peek Queue Message 以及 Remove Message 的細節, 以及使用 SQL Statement 作整個敘述上的簡化.
BASE 的作法當然可能在 Sub Transaction Fail 時引起 Inconsistency 的問題, 但是透過適當的 Traceback 機制, 我想應該可以快速的作 Error Recovery, 例如在 Master Transaction 送出的 Messages 上標記特殊的 Tag, 一旦出問題就可以追蹤到所有相關的 Transactions. 但是文章內容沒有對 Error Recovery 的處理部份著墨太多.
BASE 的應用關鍵我認為是在 Transaction 的結果事實上是應對到不同的使用者上, 包含 eBay 系統本身, Seller 以及 Buyer. 由於並非同一個角色, 因此在這些 Transactions 進行時所實際短暫產生的 Inconsistency 不會被三者察覺到 ( 除非 Seller 跟 Buyer 即時溝通確認 Consistency ). 而技術上來說, BASE 也沒有刻意隱藏 Temporal Inconsistency 的事實, 只是當 Seller 與 Buyer 角色分開時, 他們各自無法透過 Partial Information 去推知 Inconsistency 的發生罷了 :p -- 當然, 這也暗示了 BASE 的應用領域相較於 ACID 來說是會比較受侷限的.
從這點回頭來看這篇文章被放在這期的 ACM Queue 是很有趣的事情. May /June 這期的 ACM Queue 主題是 Object-Relation Mappers. 其他三篇文章都在講 ORM, 唯獨這篇殺出 ACID 與 Consistency/Availability 的問題. 是意外嗎 ? 或是 BASE 的方法事實上是把 eBay System 中的 Objects 與其 Behaviors, 給 Mapping 到了 Relational Database 中了 ?
References
[1] Dan Pritchett, "BASE: An ACID Alternative," ACM Queue, vol.6, no.3, May/June 2008, visit online version
My Activity, My Life Calendar, My Swurl: Operating the Lifestream
跟隨著 RWW 文章 Swurl: Your Lifestream, Made Beautiful 的腳步去試用了Swurl -- another Lifestreaming Service.
基本功能上其實沒有甚麼好說的, 跟 FriendFeed-like 的 Services 雷同, 甚至可以說現階段功能上不如 FriendFeed 來的好. 但是我喜歡他的 Visualization, 雖然概念簡單, 但是很強大.
Swurl 並非像 FriendFeed 一樣只是把蒐集來的資訊依新舊排列, 而是再多提供了一個類似 Calendar 的整理方式, 以時間軸, 只紀錄有活動天數, 形成一個 Life Calendar Matrix. ( 以下借用 RWW 文章的圖, 我的只有文字不太好看 :p )
Visualization 的目的一般是為了把 Invisible Information 變成 Visible.
在 Swurl 的 Life Calendar 上, 提供了一個介於統計式每日每週文章照片數量, 到 Blog 式落落長文章串之間, 折衷的摘要總覽介面. 輔以 Calendar 的 Metaphor, 我們會很自然地把相近日期的事件連結起來, 於是過去一天, 一週, 一月, 一年, 很快地就可以在你的腦海中流逝而過. 在每天每天每週每週 Blog 文章跟照片, 多媒體資料之間, 其實我們都遺漏 / 篩選掉了很多細節, 心情的轉換...... 這些東西我們沒辦法, 也不可能一一記錄下來, 但是透過 Life Calendar, 就像整理舊相簿一樣, 時間可以在手上流過, 本來一點一點的文章照片, 就可以銜接變成一整串記憶之流.
我想 Swurl, 以及他的相似 / 後繼者,會逐漸揭露一個方向 : 把Lifestream 的焦點從紀錄, 開始轉移到操作上. 就像編輯家庭錄影帶, 透過不同的操作, 我們可以再次提供不同的觀點, 不同的交集, 不同的思考, 以及不同的懷念 -- 為什麼我又會想到羅賓威廉斯的迴光報告 ( The Final Cut, 2004 ) 呢 ?
btw, My Swurl : http://selain.swurl.com/
Evri, The First Try
昨天 Sign Up, 今天就收到 Invitation 摟 :)
不過目前開放的試用內容其實讓人有點失望. 首先是內容其實跟之前在 Evri Blog 上看到的圖片差不多, 再來是 UI 操作上沒有我想像中的那麼具有 Revolution.
目前有 Most Popular People, Most Popular Places, 以及 Most Popular Things 可以選擇. 但是任何一個項目都還沒有辦法讓你自己指定 Search Keywords. 換句話說我想 Search Evri 是沒辦法的, 只能選擇他 Popular 列表上對象. 這個正式開放後應該會可以進行 Keyword Search, 不然可能一整個月 Popular List 都不會變阿 = =
左邊是 Most Popular 列表, 右邊是最近的 Rising & Falling 列表, 中央是 Evri 所謂的 "Data Graph". 下方則是關於主題的文章列表, 但是決定出現文章順序的演算法未知.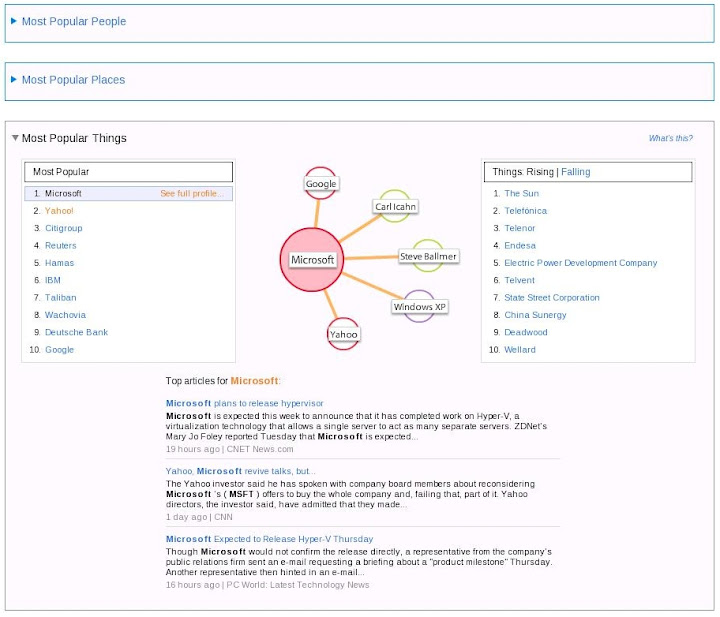 點選主題旁邊的 See Full Profile 可以看到關於主題的更詳細資訊頁面. 左下方的 "What's happening with ... " Section 有點意思, 基本上利用 Keywords 作為 Indexing, 對於相關的 Information 做了樹狀分類, 因此可以快速地選擇關鍵方向瀏覽該方向的 Information.
右下方則是針對主題所建立的 Profile. 不過 Profile Template 應該需要知道對像是 People, Place, Company 之類的才有辦法建吧, 一般雜亂的 Things 要怎麼建 Profile ? 因為 Evri 給的 Demo 裡面在 Things 部份幾乎都是 Company, 不知道未來這部份會如何處理.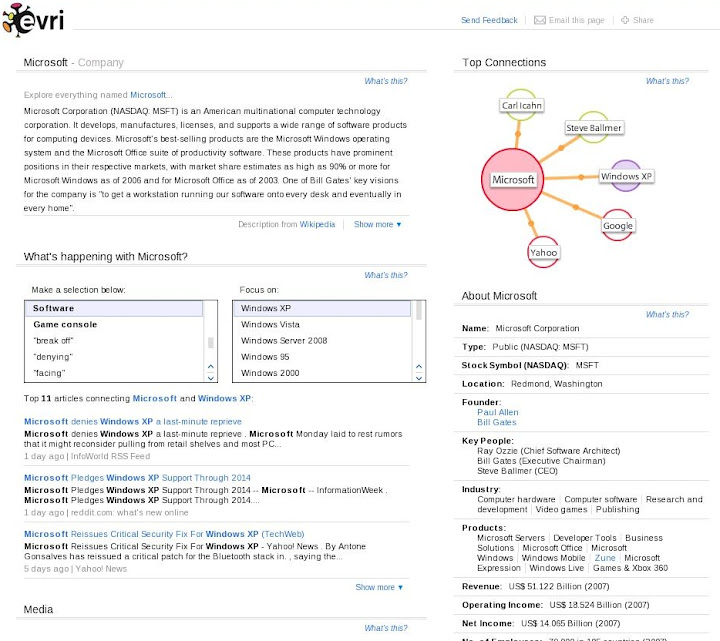
至於所謂的 "Data Graph" 或是上圖的 Top Collection 部份, 實際的作用沒有想像中的大. 基本上就是利用視覺化的方式告訴你哪些其他主題與你目前所觀看的主題相關度最大, 但是並沒有實際的搜尋導引作用, 你無法透過此 Data Graph 來快速切換主題, 而是必須透過左下方的文章內的關鍵字連結來切換主題. 會這樣設計應該也是有理由的. 可能的原因是點選 Data Graph 內的其他連結點是用來更新下面的相關文章到特定個關聯方向, 而不是一下子就切換到其他主題去.
好吧, 我想大概就是這樣了, 我應該沒漏掉什麼東西, 整體來說並沒有太多令人驚艷的設計, 這使得我不是很看好 Evri ="= , 除非正式開放之後出現其他的爆點摟. 以目前 Evri 的能力來說, 我認為 Google 想要的話大概一週 ~ 兩週就可以完成同樣的 Beta 服務網站, 甚至資料量會遠勝 Evri. 因此不管 Evri 是否能打響第一炮, 都很難令人對其前景樂觀, 加上技術難度不高, 要複製很容易, 使得 Evri 想賣個好價錢大概也很困難.
希望 Evri 能讓我看走眼摟 ~ 這樣事情會比較有趣 :)
Evri : Yet Another Semantic Search Engine ?
上個月 Evri -- 號稱是嶄新的 Content-based Search Engine -- 在 6th D Conference 上有了 Demo. ( 以下圖片引用自 D6, evri session photos )
在 RWW 的介紹文章 Evri Beta Launches: Search Less - Understand More 下, Falafulu Fisi 給的回應其實還蠻中肯的 :

...... there is nothing new here. The technique they used has been around for a long time and it is called, Latent Semantic Indexing (LSI) ...... The only thing that matters in the domain of search if one can show that his/her system has higher recall capability than his/her competitor or similar system out there......
的確以目前可得的資訊看起來, Evri 也是基於對 Content 進行 LSI 或其他 Semantic Web Analysis 來建構整個 Search Topology, 這點從 Evri 的 Hiring 資訊也看得出來. 不過如果我們再更仔細一點去看 Evri 的 Blog ( ㄜ... 雖然文章很少 ), 在 6/24 的 Little Room 文中說道 :
...... And, even with great semantically-aware data, it’s all about the UI. Evri is building a “data graph” that shows interesting and useful connections to explore about things in the outside world-things that aren’t part of your social graph.
我覺得 Evri 光明正大的提到 UI 是件很好的事情 ( 這個 UI 讓我很想試用看看阿 ). 利用 Semantic Web 的 Content-based Search Engine 在這一兩年陸陸續續地出現, 但是有哪個真正吸引了大眾的目光, 有哪個真的足以威脅到 Big Three Search Engine : Google, MS Live Search, Yahoo 的佔有率 ?
以 Business 的角度來說, 或許像 Evri 開始改用 User 的角度來思考, 希望透過更好更易懂的 User Interface 來包裝 Semantic Web 會是一個不錯的嘗試. 不用想要去教會 User 什麼是 Semantic Web, 因為 Semantic Web 本來就存在我們的腦袋跟生活裡, 而是透過 UI Languages, 讓 User 很容易地在 Computer System 上操作 Semantic Web, 補足缺少的資訊區塊.
回頭來看 Evri 的標語 : Search Less, Understand More.

看起來似乎很合理, 不是嗎 ? 我已經 Sign Up 了, Evri 快點公開讓我用用看吧 ~
WikiCafe : Wiki for Video
( 原始報導請參考 ReadWriteWeb 上 Marshall Kirkpatrick 的文章 WikiCafe: MetaCafe Invites Users to Edit Video Metadata )
影音分享網站 MetaCafe 提出了一個有趣的實驗性計畫 : WikiCafe.
顧名思義 MetaCafe 希望把 Wiki System 目前在文字文件的成功模式複製到影像文件上, 不過 WikiCafe 現階段還僅止於把 Vedio Metadata 以及 Commentary 給 Wiki 化, 把 Vedio Tagging 的修改權力從 Vedio 分享者擴張到整個 Community.
首要的考量當然會是 Metadata Quality 的問題, 在 Marshall 的文章中也提到 MetaCafe 的 Community 整體素質比起 YouTube 來的高, 因此計畫成功的可能性也比較高. 不過我懷疑 MetaCafe 的 Community 素質高跟他目前的主要使用者族群有關, 如果 MetaCafe 的使用者族群分佈跟 YouTube 趨近的話, Community 素質是否還能維持就很難說了.
因此管理制度還是很重要的, 即便是 Wikipedia 也免不了面對此問題. 在爭議性高的議題上, 例如中國與台灣主權的問題, Wikipedia 也相當依賴頁面管理者仲裁, 甚至暫停管制該頁面的自由更新. MetaCafe 是否能複製 Wikipedia 的成功, Community 自身的管理制度我想會是成敗關鍵.
而在 Marshall 的文章中也提到另外一個 Versioning 的問題.
純論 Metadata 的 Versioning 問題, 也跟上述的管理制度有關, 同時我想透過 Wiki-like 的方式解決應該沒有甚麼問題. 會有問題的可能是 (1) Vedio 本身的 Versioning 問題, 以及 (2) Vedio 與 Metadata 之間的 Versioning 問題.
Vedio 本身的 Versioning 問題指的是當原作者修改了 Vedio, 甚至是 Community 修改了 Vedio 之後的 Vedio Version Control 問題. MetaCafe 並沒有提到 Vedio 本身被修改的事情, 當誰說不可能呢 ? 我們有 Open Source Software , Open Source Hardware, 還有 Open Disk Spaces (例如 000webhost.com ) , 也許下一個流行的就會是 Open Source Media :p ( 扯遠啦 ~ )
同樣的, Vedio 與 Metadata 之間的 Versioning 問題也來自對於原本 Vedio 所進行的修改. 在 Vedio 經過修改之後, 原本的 Commentary 是否還適用呢 ? 是否所有經過修改的 Vedio 都必須被視為新的 Vedio, 無法跟之前的 Commentary 拉上關係呢 ? 到目前為止好像沒有看到哪家 YouTube-like Website 針對這個問題提供管理服務.
不過解決方法其實已經具雛型了. 在 André Santanche 的 Fluid Web [1] 中其實就說明了類似的模型, 以及對於 Versioning 的解決方案. 如果可以被成功用上的話, 應該可以大幅降低 Versioning 管理的 Cost.
References
[1] A. Santanche and C. B. Medeiros, "A Component Model and Infrastructure for a Fluid Web," IEEE Transactions on Knowledge and Data Engineering, vol. 19, no. 2, pp. 324-341, Feb. 2007
MIT Quickies : Post-it 數位化
又是一個 Physical / Virtual World 融合的例子. MIT 的 Quickies 計畫把 Post-it 數位化, 主要利用 RFID, AI, OCR 辨識, Context-Awareness & Knowledge Reasoning 等等技術. 在特殊的撰寫紙條 ( Sticky Notes ) 上裝有 RFID, 因此可以進行追蹤管理, 同時利用 Digital Pen 在撰寫紙條寫字, 可以自動把內容擷取到 PC 上, 透過 OCR 進行內容辨認, 最後利用 Knowledge Reasoning 以及 AI 決定 PC 會相對應自動採取哪些動作.
在 Project 網頁上也寫了 :
The project explores how the use of RFID, Artificial Intelligence and ink recognition technologies can make it possible to create intelligent sticky notes that can be searched, located, can send reminders and messages, and more broadly, can help us to seamlessly connect our physical and digital worlds.
個人認為重點在於最後的一句話. 從這句可以看出 Quickies 的 Power 在於自動把現實生活中的物件, "拷貝" 進 PC 的虛擬世界中的能力.
Quickies 的 Data Flow 架構設計可以參考下圖 ( 以下各圖均取自 [1] )

整個流程包含 :
- Sticky Notes 透過 Digital Pen 以及 RFID 將資訊輸入到系統中, 先以原始資料存在,
- 而後再利用手寫辨識 ( Handwriting Recognition ) 轉換成為電腦可辨識文字訊息,
- 之後在螢幕上以便條紙的形式把訊息 Show 出來,
- 同時透過 Context-Awareness 系統以及 Commonsense Inference Engine ( 我的專長之一 :P ) 推論出相關的 Knowledge, 以及之後可能需要啟動的相關軟體服務,
- 最後透過一個 Mediator 把相關資料傳給所有負責進行服務的軟硬體.

其實我覺得除了 Post-it 本身的使用方式, 以及利用 RFID 對物品作追蹤管理之外, MIT 的 Quickies 還有一個可能十分強大的應用 : 作為 Smart Home 的命令輸入器. 過去 Smart Home 的命令輸入還是以遙控器類型的為主, 語音辨識會有口語差異大, 各語言辨識轉譯, 以及因為生病等因素導致腔調改變的問題. 而 MIT Quickies 其實可以作為一個短期內 ( 可能是四五年左右 ) 可以接受的過渡性產品. 大部分語言的手寫辨識其實已經有一定的辨識完成度, 因此技術挑戰比語音辨識來的小. 只要會寫字, 甚至會畫圖, 就可以控制 Smart Home 了.
另外值得一提的是, 這個計畫可能有台灣人參與過一部分的作業. 在 Paper [1] 的感謝欄中, 提到了一位 Dawsen Hwang :
Acknowledgements
We thank Professor Hiroshi Ishii and Professor Henry Lieberman for their valuable feedback and comments. We would also like to thank Dawsen Hwang of NTU and the fellow MIT Media Lab members who have contributed ideas and time to this research.
很用力的透過 Google 查了一下, 應該是台大電機 108 級 ( 還是 109 級? ) 的黃道生 ( Dawsen Hwang ), 不過不知道怎樣跟 MIT 搭上關係, 可能是交換學生, 或是畢業後到 MIT 繼續攻讀學位了吧. 不管怎樣從 Google 到的資料可以看出也是強者一名就是了.
References
[1]Pranav Mistry and Pattie Maes, "Quickies: Intelligent Sticky Notes," Proceedings of 4th International Conference on Intelligent Environments (IE08). Seattle, USA. 2008
Jiglu : Automatic Article Tagging
Jiglu 能夠自動擷取你的 blog 內的文章內容(當然是在你的允許之下), 經由適當的分析(其實是不知道他怎樣分析), 會自動產生出一組標籤, 可以用來作為你的 blog 內的文章之 index terms (tags).
(以下圖片取用自 Jiglu 官方網站)
如上圖所示, 你可以根據自己的生活在的 context 紀錄下各種主題的 information (articles), 存放累積在一個 blog 內, 而 Jiglu p 分析結果產生的 index terms (tags), 把這些 articles 作 grouping 以及 connection.
connection 的方式是透過在不同 group 內的相同文章作 group 間的 connection.
我認為 Jiglu 算是 Horris Wu [1] 等人的 collaborative document repository 的簡易版之實現, 透過在 Jiglu 官方網站提供對於不同的 blogger 之間的 articles, 利用共同的 tags 進行收納, 則可以連結不同使用者的 information (articles).
不過實際試用一陣子, 覺得 Jiglu 在 blogger 上的使用還沒有想像中的強大 :
- 第一, 還沒有支援中文, 只有英文的部份,
- 第二, 只會整理 blogger 目前頁面上可以看到的文章, 之前的似乎不會列入關鍵字統計分析 ( 或是我沒有設定好 ? )
- 第三, 利用他額外的功能, 例如 TreeMap 等等, 速度超級慢, 不是一般使用者願意等待的時間
- 第四, 我本來期待他的 service 真的 smarter [5] 一點, 但是結果似乎也只是一般的關鍵字分析, 沒有類似 ontology 的關鍵字關係幫助使用者建立較具有意義的文章連結結果, 或是會自動推測文章的 related contexts
References
[1] H. Wu and M. Gordon, "Collaborative Structuring: Organizing Document Repositories Effectively and Efficiently," Communications of the ACM, vol. 50, no. 7, pp. 86-91, July 2007
[2] Jiglu 官方網站 : http://www.jiglu.com/
[3] Jiglu 社群網站 : http://www.jigluhood.com/
[4] 相關文章 : Jiglu 用自動化標籤來找出部落格內的相關文章, http://playpcesor.blogspot.com/2007/10/jiglu.html
[5] 相關文章 : Jiglu: Smarter Contextual Tagging, http://www.zoliblog.com/2007/10/15/jiglu-smarter-contextual-tagging/
[6] 相關影片 : Jiglu: Automatic tag creation for bloggers and web publishers, http://www.downloadsquad.com/2007/10/16/jiglu-automatic-tag-creation-for-bloggers-and-web-publishers/
Domain-Driven Vedio Sorting ?
剛剛看到 YouTube 上似乎增加了新的 sorting 方式, 本來是在利用 keywords 進行搜尋過後, 可以有 Relevance, Date Added, View Count, 以及 Rating 的 sorting 方法,
現在多了 Today, This Week, This Month, 以及 All Time 的選項. 但是我實際試了結果好像沒有作用, 還沒有作用的功能會先放上來嗎 ? Anyway, 從選項看起來, 我猜應該是可以進一步對於 sorting 的結果作切割吧, 例如 Date Added 加上 This Week 的話, 就只會看到利用 keywords 找到的 Videos 中, 只列出於本週內加上的 Videos, 依照 Data Added 的新舊順序列出. 雖然不是什麼突破性的 sorting 功能, 但是增加這個利用 Time 來切區塊的參數, 就可以讓 sorting 的效率增加不少.
玩著玩著就想到, 以後不知道會不會出現 Domain-Driven Video Sorting. 顧名思義, Domain-Driven Vedio Sorting 就是會針對你要找的 Videos 所屬的 domain, 有專用的 (specific domain) 最佳化過 ( optimized ) 的 sorting 方法.
講到最佳化好像就會變的很複雜, 要用一堆數學, 其實根本不用啦, 舉例子來說, 我上面的兩張圖片是在找韓國星海職業比賽的影片, 想看 Bisu 對上 Stork 的最近三場比賽 Videos, 而 YouTube 目前只有上面說的兩種 sorting 方法, 這兩種 sorting 方法事實上是普用性的 ( general purpose ), 對於哪個領域都可以適用. 但是在星海職業比賽內事實上有一些領域邏輯 ( Domain Knowledge & Logic ) 在, 例如這是 OSL 或是 MSL 的聯賽, 是單場 (1 set) 或是三連戰 ( 3 set ) 等等. 這些領域邏輯應該可以被用來進一步增加 sorting 的效率.
再舉個例子, 如果今天我是找 NBA 短片 Videos, 我可能可以利用聯盟分組 ( Division ) 與否的方式來為找到的 Videos 切段, 在 NBA 官方網頁上已經有類似的區分方法, 不過是用來看戰績表的.(噗, 不小心把姚明跟 Garnett 剪進去, 沒辦法今天沒馬刺戲份)
換句話說, 當我們在 YouTube 上根據某些關鍵字找到某些影片之後, YouTube 會自動根據你找到的影片之領域特性, 提供你除了普用性的 sorting 方法之外的, 此領域專用性搜尋方法, 因此究竟你每一次的搜尋可以用到哪些 sorting 方法是動態 ( Dynamic ) 決定的. 而至於 sorting 方法的產生就不一定, 要容易作點或許可以利用 Domain Ontology 推演出來, 這樣八成就會是靜態的 ( Static ), 複雜點的話或許 sorting 方法會是 self-evolved, 這方面就超越我所知道的領域了.
不管是哪樣, 可預期的, 服務都是越來越往我們的真實生活在靠攏, 我們需要遷就電腦軟體的地方只會越來越少.
Multimedia Analysis and Retrieval System (MARS)
最近因為 lab group meeting 的關係看了一篇平常大概不會特意去看的 paper : Supporting Ranked Boolean Similarity Queries in MARS [1].
這是 98 年的 paper 了, 內容主要是提出一個改進的 boolean retrieval model, 以產生 ranked retrieval results. 而應用在 multimedia analysis and retrieval system (MARS) 上, 不過 paper 內只有提到 image, 沒有 film 之類的, 估計是因為差別在於所選擇的 features 而已.
這篇 paper 有幾個值得深入討論的地方, 首先, 雖然他是 10 年前的 paper 了, 但是在當時他所使用的 query 就不只是利用 text-based 方式在描述 image 的 features 了. 他是用一組 images, 稱為 set I 好了, 裡面的 iamges I1, I2, I3... 分別用來表示一組 features, 稱為 set F 好了, 裡面的 features F1, F2, F3...., 換句話說, 是利用多個 images, 各取你覺得有用的部分, 合起來去尋找你真正想要的 image.
很容易就想到白蘭氏的這個廣告.
這種想法在現在來說應該已經不新奇了(特別是對 CS domain 的人), 我在看 paper 的同時也去找了目前有提供相似功能的 product, 但是找到的 image retrieval softwares [2][3][4] 似乎都只支援 text-based features, 以及 single image retrieval, 而沒有 multiple image retrieval 的, 不知道是為什麼 ? 其中 CIRES 支援 signal image retrieval, 可以調三個 features, 可以線上使用, 只是搜尋要等一段時間. 另外可以看看據說是 T. S. Huang 的學生在網頁上所放上的, 他們實驗室作的 MARS 的 screenshots : 在這裡 [5]. 通常我們說 academy 的研究成果是領先 industry 大約 6 ~ 7 年的時間, 但是都過了 10 年了卻沒有相似的 product 出現, 這點實在有點奇怪.
另外當進行這一類搜尋時, 勢必須要從固定的 selected image base 中選定作為 features 的 images. 然而 selected image base 除了需要事先分類過以外, 其 size 也會對於整體 performance 造成很大的影響. 第一個影響是 user 需要花費多少 effort 去形成他的 query. 另外一個影響是所形成的 query 之準確度. 如果 selected image base 中的分類不夠好, 或是 size 太大, user 會需要花較多的時間形成 query, 同時準確度也不見得會比較好. 而 size 太小, 顯然地 query 就比較難準確, 得到的結果一定會比較差. 這之間的 trade-offs 不知道該如何衡量.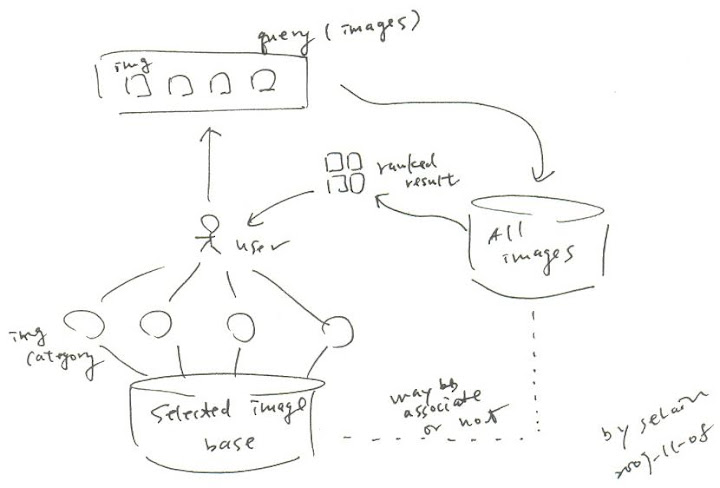
想像當我們到警察局要依照分類過的特徵照片拼湊犯人長相時, 如果需要看個一兩千張照片來拼湊一個 image set 作為 query, 應該會想扁警察吧. 但是如果只有一二十張, 我們一定又會覺得沒辦法選出想像中的 features, 結果當然也就不會好.
就 feature set F 來說, 其組成也是需要探討的地方. 通常 features 之間不會全然是 independent, 同時我們也不可能要求 user 要填寫三四十個 features 才能準確搜尋. 因此怎樣選擇可以造成最大區別度的 features 是另外一個問題. 在 paper 中選擇了 colors, texture, shape, color layout, 以及 textual annotation 作為 feature set. 然而我想實際上 feature set 的選擇可能會跟 image base 裡面究竟存哪些 images -- 換句話說目前應用的 context 是什麼有關係, 唯有考慮 context 的問題才有可能決定最有效率的 feature set.
另外 paper 內容有一點很有趣, 他使用了兩個 form 來表達 pseudo code, 一個是常見的 text-based pseudo code 形式, 另外一個是有點像流程圖的方塊形式 (我以前沒看過這樣畫的), 講的是同一個 algorithm, 但是兩個要表達的東西又各自有點不同, 所以你也不能批評他說是多餘的. 倒是 paper 內也沒有解釋為什麼需要特別用兩種方式表達就是了, 或許是因為整合起來會太複雜吧, 分開成兩個簡化的 view 效果一樣, 各自有各自的焦點在, 就跟 UML 需要分成好幾個 view 一樣. ( figure bellow is referred from [1])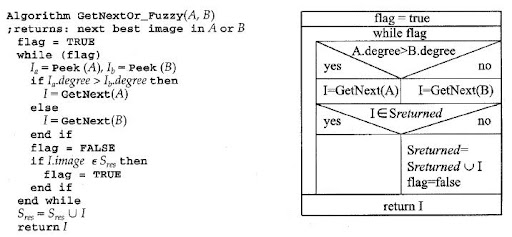
雖然跟我的 major domain 稍微有點距離, 很多 detail 也看不太懂, 但是從單純 information retrieval 的角度去思考, 以及想到 multimedia retrieval 應用的可能問題, 還是蠻有意思的一篇 paper.
References
[1] M. Ortega, Y. Rui, K. Chakrabarti, K. Porkaew, S. Mehrotra, and T. S. Huang, "Supporting ranked boolean similarity queries in mars," IEEE Transactions on Knowledge and Data Engineering, vol. 10, pp. 905-925, Nov/Dec 1998.
[2] CIRES, URL : http://cires.matthewriley.com/
[3] imgSeek, URL : http://www.imgseek.net/
[4] GIFT, URL : http://www.gnu.org/software/gift/
[5] MARS snapshot, URL : http://www.ifp.uiuc.edu/~qitian/MARS.html
以 Information & Knowledge Engineering 的角度看 Software Bundle
lazybuntu [1] 是國內著名 bbs/web browser 軟體 PCMan 的作者(也叫 PCMan :p)發起的計畫, 就如同其他 lazyxxx 計畫一樣, 是希望透過把常用的, 好用的 softwares 綑綁在一起(software bundle), 並設定好在特定 platform 上的安裝設定以及 package deployment, 使得在該 platform 上的使用者可以快速地安裝好必要的 softwares. 當然會這樣作的原因也包含了在原來的 distributions 中並未能夠考慮特定區域的使用習慣來決定內建的 packages 支援, 或是因為 packages 太多反而讓一般使用者不知道怎樣選取.
相似的東西, 最近國內比較 hot 的應該是 lazyeeepc [2] 吧, 而我之前為了求方便分別在 Linux 以及 Windows 上也使用過的 XAMPP [3] 也算是類似的東西. 但是我認為從 information & knowledge engineering 的角度來看, 這些 software bundles 之間還是有所不同.
如果只是從 把常用受歡迎的 softwares 一起包裝起來 的角度來看 software bundle, 那麼 software bundle 其實可以被看為是一個 packaged information aggregation. 在此 aggregation 內, softwares 是以特定的關係被 connect 在一起, 但是這樣的關係只會是 在同樣 platform 上的關係, 或是跟某個 programming language 相關等等的關係, 並沒有包含這些 information 怎樣以有方向性的關係作連結的資訊.
以 XAMPP 的例子來說, 有意識地選用了特定的 software 組合, 意味著完成 XAMPP 的 developer 認為這樣的組合在他的使用經驗中具有某種優勢, 這樣的組合是對於他來說是有意義的. 而有意義意味著對於 Information 的認知能夠提供他使用上的某種經驗, 於是 Information with Meaning 就變成了 Knowledge.
更甚而可以形成某種解決問題的 pattern, 擁有合適的 context description, 以及使用此 software bundle 時需要考慮的 forces, 使用後的 consequences 等等, 這就已經不再只是 information aggregation 的 level, 而是把 software bundle 作為一種 knowledge sharing 的手段了.
以 lazybuntu 來說, 其實蠻有淺力往這邊走的, Ubuntu 的使用者多, 在 Ubuntu 上的 applications 也多是兩個主要的原因. 但是要以怎樣的 format 讓 contributers 可以在 lazybuntu 上分享自己的 "knowledge" 倒是一個難題. 特別是所謂的 knowledge 是可以包含各種使用方式的, 像是 Apache 雖然是 web server, 但是我也曾經把他跟 Trac 綁在一起用, 原因只是為了利用 Apache 的密碼加密模組.
當我們可以把 software bundle 完完全全視為一個被 share 的 knowledge 時, 或許到時看到的就不再是 software 的 composition (或說是 component composition), 而是現在正開始熱的 service-orientation 的角度了. 到時我們看的不是一個一個的 softwares, 而是看到 softwares 經過適當的組合, 經過使用的測試, 匯集使用的經驗, 所提供出的 services.
References
[1] lazybuntu, URL : http://lazybuntu.openfoundry.org/
[2] lazyeeepc, URL : http://yurinfore.blogspot.com/2007/10/lazyeeepc-001.html
[3] XAMPP, URL : http://www.apachefriends.org/zh_tw/xampp.html
[4] Michael Negnevitsky, Artificial Intelligence : A Guide to Intelligent Systems, Addison-Wesley, 2001