
Game-based Competitive Learning
News from GamePro : Game design professor beta tests a new grading system ( Prof. Lee Sheldon's project )
It's not a noval idea, but always an interesting practice.
我還記得唸大學時, 聽過成大資工的密碼學課程, 期末的 Final Project 是要各組設計一套 Public Key/Private Key 機制, 然後互相嘗試攻擊, 被攻破的組別會被扣除一定分數, 相對來說攻破其他組則會加一定分數, 當時就覺得這樣作很有趣. 類似的概念我最早接觸到應該是國小時看 MacGyver, 其中有一集是大學生各自設計獨特的門鎖, 也是要設法突破對方的設計. 我們 Lab. 也早在幾年前就開始嘗試 Game-based Programming Learning 給大一學生.
多元的上課跟訓練方式絕對是好事, 但是難免會受到設計品質跟評量標準一致性的限制. 但是話說回來, 出了學校, 哪裡還有一致的評量標準呢...
不過換個角度來想, 如果不要把眼光侷限在傳統學校內, 而是放到更加專業的公司訓練課程, 或許很有發展空間. 許多公司的工作其實充滿大量的 routine work, 有遠見的老闆會設法保持員工的活力, 如果有專門的課程訓練公司, 可以為不同種類的公司及團體設計特殊, 有趣的學習課程, 而不是像目前許多應付了事的電腦職訓課程, 或許意外地有商機 ?

Paper Bad Smell Detection (2)

- Long Sentences
- Vague Words
- Countable/Uncontable Words
- Similair Words
- Verb Auxiliary + V-ed Violation
Bookmark Mindmap
前幾天在 RWW 上有一篇文章, 介紹了可以幫助 Bookmark Favorite Images 的三個 Sites : 3 Cool Sites to Bookmark Your Favorite Images on the Web. 昨天在看到一篇與 Cloud Computing 相關的文章, 並把他利用回應的方式附加到我之前的文章時, 忽然想到, 往往我們在 Web 上會看到跟之前一些想法相關的資料, 包含文章圖片影像動畫等等 -- 姑且稱為 Web Materials 好了 -- 是否可以有很容易的方法來蒐集組織他們呢 ? 之前用過 Google Notebook, 在蒐集上是很方便, 但是後端的組織就比較弱. 這種類似的系統由於缺乏比較系統化的組織工具, 因此容易出現蒐集了一堆, 後續處理反而麻煩的情況.
如果我們把自己的 Blog 視為表達紀錄自己知識的媒介, 那麼其實可以把這種組織的行為以 Blog 文章為中心作連結, 等同於以 "Adding" 的方式連結別人的知識到自己的知識上, 同時這是屬於個人式的知識累積. 很直覺的會想到利用 MindMap 來作整理. 借用 FreeMind 作個假想圖 :
利用 "Bookmark MindMap" 在 Google 做了一下搜尋, 發現有一些類似的 Tools, 例如有人替 Del.icio.us 作了 Delicious Mind Map Maker, 可以吃進你的 Del.icio.us 資料, 製作出 MindMap 來.
另外 DeliciousMind 也同樣是幫助把 Del.icio.us 上的資料以 MindMap 形式作整理與呈現的工具, 他利用了 FeeeMind. ( 這裡有額外的介紹跟 Examples )
不過這些都跟我想要的還是有一段距離. 我認為一張 MindMap 應該是以一篇 Post 為中心, 而往外擴展關係, 然而整個網站未必要是多張獨立的 MindMap, 這樣會讓 Blogger 整理到死. 相對的, 一個 Blog 本身是 Personal Knowledge Web, 而以單一 Post 為中心可以得到一個以上的 MindMaps. 這也跟之前 Library 2.0 的討論有相關之處.

Travel Plan Digg + SOA Travel Planning
最近要到蘭嶼去玩幾天 (8/1-8/4), 發現行程規劃實在是件有點複雜的事情.
從台灣本島到蘭嶼有搭飛機以及搭船兩種方式. 飛機的話目前只有台東機場有德安航空到蘭嶼的航班, 其他地方沒有.搭船的選擇就比較多了, 台東富岡有, 也可以從屏東後壁.
如果說旅程規劃沒有任何彈性, 事情就簡單許多, 但是選擇也相對變少. 比如說就是要從台北到蘭嶼, 然後日期就是 8/1 到 8/4, 那麼大約只剩下台北搭火車夜車到台東, 一早坐飛機到蘭嶼, 不過這樣的旅程很累 ; 或是 8/1 早上搭火車, 但是這樣到蘭嶼的時間就變成下午了.
而如果旅程規劃有很多彈性, 像是我們的規劃, 可以接受先到台東住一兩天, 然後從容地搭飛機到蘭嶼 ; 甚至可以接受先到台南待一天, 然後從台南搭火車到台東 (大約只要三個半小時), 這樣比台北到台東快上不少, 旅程也比較不會累. 其他像是先到花蓮, 再到台東等等, 都在可以接受的範圍. 這時候再考量旅館, 交通, 食物等等相關事項, 整個規劃作業瞬間就變的很複雜.
在 Web Service 與 SOA 的研究中常見以 Traveling 作為 Service & Workflow 的 Example. 常見以 Time 為根據作行程的銜接, 以及基本的條件設定, 然後加上一些進階條件的選擇, 像是不搭船, 以及 Quality 的要求等等. 這樣 SOA 的 Solution 事實上存在很多複雜度, 除了上面說的以外, 像是 Service 的狀態要能由 Service Provider 更新, 確保 Service Abailability 以及 Quality 等等.
但是若單純以 Bottom-Up 的方式去產生可能的 Workflow, 固然可以得到最多的可能性, 但是畢竟使用者要的通常只有一兩個, 因此中間就需要透過使用者的參與來降低可能的選擇數目, 這又變成了 User Interaction 的問題.
也許因為這樣的複雜度, 許多國內的旅遊服務都只停留在 Information Portal 或是 Service Portal 的階段而已, 而不是真正的 Service Provision Forge.
我認為類似的應用應該考慮利用 Top-Down 以及 User Community 來夾出可能的選擇, 進而大幅降低一般使用者的負擔, 同時確保規劃結果的品質與可行性.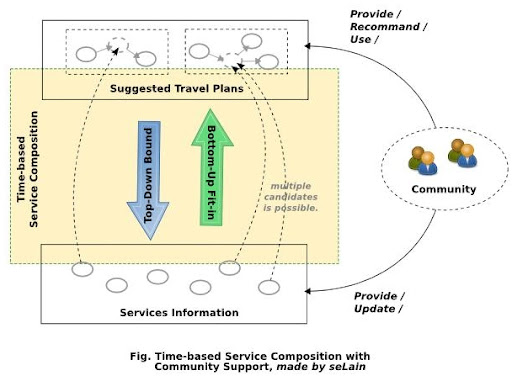
方法就是利用現成的 Travel Plan 作為 Incomplete Workflow 去套可得的 Services. 可以想像一個類似 Digg 的 Travel Plan 推薦子系統, 由一個 Community 維護. Community 成員可以貢獻自己的 Travel Plan, 作為基本的 Template, 而其他成員是以一個 Travel Plan 為單位進行推薦以及參考. 而反過來, Community 也能夠提供 Single Service 的資訊, 有利於一般 Service 資訊的更新與正確性.
當然, 免不了地 User Interface 依舊會是關鍵, 必須要能夠盡量降低使用者輸入以及推薦 Travel Plan 的 Effort, 才能夠在使用者可以得到的幫助與付出之間取得平衡. 另外必須有 Formal Travel Model, 而不是向許多旅遊網站只是讓使用者以 Natural Language + Free Style 分享旅遊心得. 既然要從使用者端取得資訊來再利用, 就應該有系統地蒐集以及使用.
不用把資訊的取得想的太複雜, 也不要期望旅途中相關的商家旅館會時時更新訊息, 單純依靠 Community 的力量來建構這樣的環境, 有效地在資訊進來之前就先篩選, 同時也讓回給使用者的規劃有最高的有效性.
Beyond Single-Page Web Search Results, and ... What's The Next ? Community Page Ranking ?
本週實驗室會議由學長報告了 [1] 這篇 Paper. 其實之前我旁聽實驗室另外一個 Project 的進度會議時就已經大略看過這篇了, 不過本週趁機重新看一次, 反而有些新的想法 -- 可見得有些 Paper 時不時要多看幾次.
這篇 Paper 的基本概念很簡單, 解決的問題很小 ( 或者該說精準 ) 但很實在.
目前的 Web Search Engine 基本上是以 Single Web Page 作為單位進行關鍵字比對, 然後把符合或部份符合的 Pages 傳回, 通常會依照符合的程度進行排序 (Ranking). 不同的 Search Engine 可能會有額外的 Ranking Factors, 像是 Google 有自己著名的 Page Ranking 演算法, 另外考量商業廣告因素, 關鍵字出現頻率等等, 可以對於排序演算法再做調整.
但不管怎樣作排序跟 Page Ranking, 以 Single Web Page 為單位就會出現, 用了多重關鍵字進行搜尋, 但是沒有任何一個 Page 完全符合關鍵字組的情況. 使用者必須由列出的 Pages 之中, 瀏覽排前面數名的 Pages, 才有可能得到真正想要的資訊. 這大致符合我們的使用經驗.
Paper [1] 的想法則是, 把原本 Single Web Page 的情況, 進步到 Multiple Web Pages -- 既然我們本來就會需要瀏覽多個 Pages 來得到我們想要的東西, 為什麼不在 Search 時就直接給我 Multiple Pages 的比對結果呢 ?
( 下圖修改組合自 [1] 內容的截圖 )
因此 Paper [1] 把 Multiple Pages 結合起來成為一個 Composed Page 作為搜尋結果. 但是 Multiple Pages 也不能亂選, 否則可能造成內容事實上差距很大, 不相干的東西被包裝在一起, 因此考量了 Pages 之間應該會有 Hyperlink 的關係. 同時 Composed Page 內也要避免因為 Pages 太多不好快速瀏覽, 因此針對一個 Page, 也提供了 Query-Specific Summarize 的演算法, 藉由把一個 Page 的文字內容作切段, 以 Query 用的關鍵字組為依據, 利用 Text Information Retrieval 的方法, 以及 LSI 技術, 建立一個 Page Graph, 然後計算出具代表性的部份作為 Summary. 而多個 Pages 在 Summarize 過後進一步把 Summary 結合成為 Composed Page. 詳細的演算法在 [1] 中有說明.
從 User Query 的觀點來說, Paper [1] 注意到越來越多使用者傾向使用關鍵字組作為 Search Context 的 Abstraction, 並期望找到的資訊可以填到 Search Context 中. 而過去 Single Web Page 的作法使得使用者要自己負責彙整 Single Web Pages, 透過 Hyperlink 去找尋 ( Explore ) 更廣的資料, 然後歸納出一個有用的 Page Set 出來. 而此篇 Paper 稍微前進了一步, 在可以幫忙進行事前整理的範圍內, 先把相關的 Pages ( 可能橫跨 Websites ) 做了整理, 同時以 Summarize 過後的內容結合成一個 Composed Page, 來逼近 User 的 Search Context.
從 Single Web Page Ranking 到 Multiple Web Page Ranking ( Summarized, Composed Page ), 下一個階段會是甚麼呢 ?
Community Page Ranking 或許有機會. 不管是 Single Web Page Ranking 或是 Multiple Web Page Ranking, 基本上如果你輸入的是一樣的關鍵字組, 結果應該是一樣的, 換句話說對於所有使用者來說是一視同仁的. 這也是因為我們無法事先預測可能的使用情況 ( Search Context ), 因此只好這樣作. 但是如果可以鎖定一個 Community, 透過 Community Member 就可能定義出屬於該 Community 的可預測 Search Contexts, 這時候要更進一步對於 Pages 作事前組織就是有可能的事情. 同樣的 Pages Set 在 Travel Community 與 Local City Community, 使用同樣的關鍵字組, 可能會是得到不一樣的 Composed Page.
感覺 Google 已經開始透過 Knol 希望逐漸建立可信賴的 Knowledge Group 了, 或許將來與 Community 在 Knowledge Search 方面會有更加深入的互動.
References
[1] R. Varadarajan, V. Hristidis, and Tao Li, "Beyond Single-Page Web Search Results," IEEE Transactions on Knowledge and Data Engineering, vol.20, no.3, pp.411 - 424, March 2008
Twitter + Google Maps Should Go Beyond TwitterVision
Google Maps 現在也加上 Walking Direction 的資訊了( RWW 也有相關文章 ), 這基本上是一個必然的動作, 能夠讓地圖提供更有效率的幫助. 即便是在有了各種電子地圖後, 查閱地理資訊變得更加容易, 自動規劃路程也變得可能, 然而缺乏更加詳細的資訊卻讓許多理想的服務無法完成. 像是 UrMap 也遲遲未能提供台北縣市以外的大眾交通工具資訊, 以及路線規劃只能提供汽車, 沒辦法照顧到機車族群. 我認為問題不在於 Algorithm 的設計以及 Computation Power 的限制, 而在於 Valid Data 的取得.
透過 Sensor 或是 GPS Devices 固然是一種方式, 也常用於自然災害偵測與防治以及疾病控管等大範圍監控系統上, 但是幾乎都是透過衛星傳輸資料, 要在城市中使用, 為了降低成本需要仰賴於城市無線網路基礎設施, 同時即便如此, 大量的 Sensor 裝設費用仍然很嚇人.
在這些困難下, 其實過去的警廣交通網作法, 反而是可以讓人考慮的一條路. 台灣主要道路的路況是由熱心的駕駛回報到警廣, 然後由警廣彙整略加查核後由廣播通知鄰近其他駕駛人
同樣地, 我們可以期待類似 Twitter 與 Google Maps 的結合. 透過 Twitter, 使用者可以時不時地簡短報告自己周圍的地理狀況, 然後以 Google Maps 作為具體呈現的平台, 廣播給大家知道. 已經有類似的服務在 TwitterVision 被實現. 相關的主題也可以在 Google 上利用 "Twitter Google Maps Mashup" 作為關鍵字找尋, 有相當多的討論.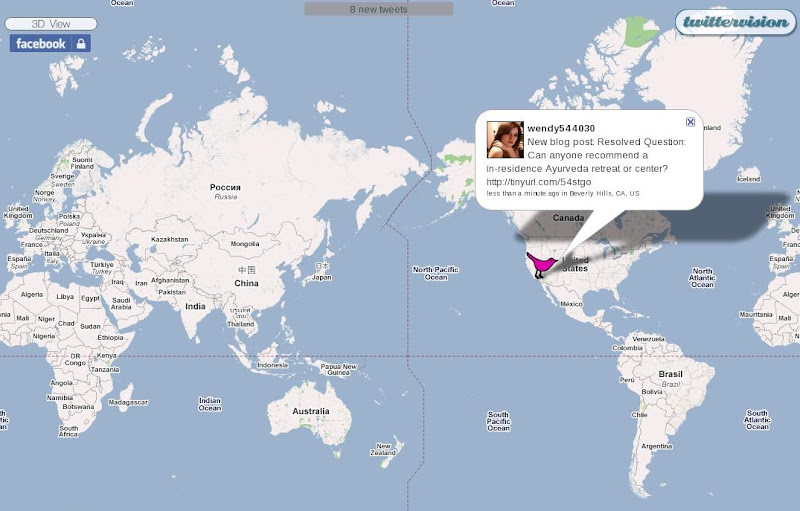 然而 TwitterVision 也只是讓 Twitter + Google Maps 發揮 1 + 1 = 2 的效果而已, 我們需要讓 1 + 1 > 2 .
透過 Twitter 而來的 Message 或是 Media (Photo, Vedio Clip, etc) 應該可以在使用者輸入時先作簡單的分類或是 Tagging, 然後在後端利用 Semantic Analysis & Semantic Web 以及 Image Recognition, Image Classification 對於這些資料根據 Google Maps 的基本地理條件 (Constraints) 作彙整, 針對不同使用者的使用需求, 提供即時的相關資料整理.
交通以及路況就是一個很容易處理的應用. 只要在輸入者提供一些簡單的 Template, 很容易就能得到使用者身邊有用的 Data, 然後就能夠整理成該地區有用的交通及路況資訊. 當然, 這依舊仰賴於無線網路基礎設施的鋪設, 以及手持式電子裝置的普及 -- 不過話說回來, 這時代有哪項網路服務不是建立在這樣的預想 (Assumption) 之下 ?
期待很快能看到這樣的 Product 出現 :)
Document Built-In Formation Test
昨天幫一個學弟進行碩士口試的 Dry Run, 投影片裡面要改正的小缺點相當多, 雖然說我當初在準備碩士口試時也是有不少地方需要修改, 不過倒沒有像學弟一樣出現很多有點離譜的錯誤 -- 以我們實驗室兩年的 Training 來說.
這種同 Hierarchy 字體大小不一, 條列式內容的標示混雜地以數字跟符號組成, 同時並沒有特殊意義. 還有同一頁的文字表格太多太雜等等問題, 表格文字超過虛擬邊框 (Soft Boundary) 等等.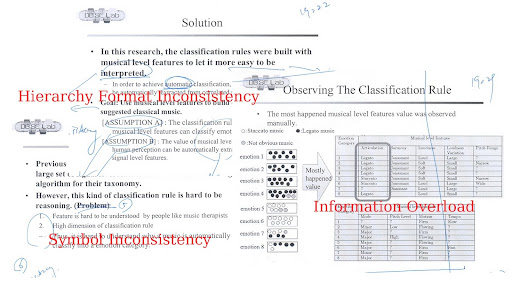
現在的編輯軟體大多有提供 Spell Checking 功能, 可能是自身內建的, 也可能是利用外部的 Spelling Checking Component, 像是 GNU Aspell 等等.
雖然說可以利用建立 Template 來軟性規範一些可能出現的 Inconsistency, 但是手殘的時候還是有可能像是上面的 Format Inconsistency.
不知道是否在編輯軟體上, 可以支援對於特定 Document Template 加上 Built-in Formation Test, 來確保 Document 中不會有不經意的 Inconsistency 出現. 像是同一個 Hierarchy 的文字大小, 粗細設定以及字體應該一致, 同一頁的文字數量以及行數應該小於某個數值, 甚至可以根據整頁的字數跟圖的複雜度所含的資訊量作檢查, 避免同一頁的內容太多且雜.
其他一些投影片製作的 Rule of Thumb 或許也可以變成一些 Tests 來協助製作在 Formation 上具一定水準的投影片.
街頭垃圾壓縮機 與 Service-Oriented Computing
在癮科技看到的這篇新聞 : 費城將在街上設置垃圾壓縮機 很有趣, 等同於是把小型的垃圾車放置在城市中固定的地點, 透過科技的進步來增加垃圾收納量, 以及降低環境污染度, 克服過去公設垃圾桶會有的許多缺點.(以下圖片引用自 KYW Newsradio)
 |  |
過去在談論 Service-Oriented Computing 時, 我們似乎都會很自然的想到各種商業應用, Shopping Services, Business Services, Travel / Hotel / Transportation Services 等等, 然而回歸到現實面, 其實還有很多非常小, 但是很實用的 Services 經常就被忽略.
像是很常遇到的, 走在街上, 可能是因為剛剛買了小吃, 飲料, 或是打噴嚏的衛生紙, 很容易的手上就會有想丟掉的垃圾. 如果是在不熟, 非生活圈的地方, 一時之間要找垃圾桶就不是如此容易的事情. 如果費城的垃圾壓縮機可以在 Service-Oriented Computing 基礎設施上搭配提供這種 垃圾 Service, 應該會讓計畫的效果更好吧.
這種 垃圾 Service 看起來很小很無聊, 可是需要的時候功用卻是很大的.
Zero-Day Copy ?
剛剛又看到一個複製網站 說你這行 (ShowUrJob) , 很顯然想法是來自於 Glassdoor.com . 透過 Community Member 的群體力量, 讓許多公司的薪資跟待遇透明化.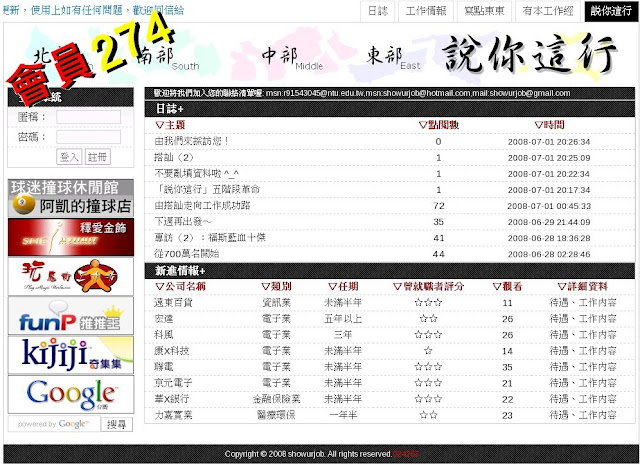
在 Software Security 領域有 Zero-Day Attack, 在 Internet Venue 領域也要有 Zero-Day Copy 了嗎 :p
不過我並不是想嘲笑 Zero-Day Copy 的行為, 相反地, 這類網站能獲得成功也相當不錯, 沒有人會嫌可以用的服務太少, 不是嗎 ?
Zero-Day Copy 的可行性我認為與 Localization 關係極大, Glassdoor.com 對於非英語系的國家還沒有那麼大的 Community, 而缺乏 Community 就缺乏資訊. 如果有相似的網站可以快速複製實現類似的功能以及制度, 藉著語言以及文化優勢搶在開拓者 ( 如 Glassdoor.com ) 之前嘗試建立夠大的 Community, 成功的可能性並不低.
在 Zero-Day Copy 中, 最難得到的 Idea 來自於別人, 要搶佔的 Resource 本來就在 Community 中, 而中間快速複製才會是重點. 因此在 Zero-Day Copy Company 中, 最重要的角色可能會是兩種人 : Reverse Engineer 以及 Project Manager. ( 為什麼我會想到 Pay Check 這部電影 :p )
這裡的 Reverse Engineer 包含不只軟體技術上的 Reverse Engineer, 還包含可以從 Social 角度進行 Reverse Engineering, 分析開拓者成功因素跟行為模式的 Reverse Engineer. 換句話說, 需要的是一個 Socio-Technical System Reverse Engineering Team.
Project Manager 就不用說了, 能夠在合理的時間跟成本下領報開發團隊完成 Software Development 的 Manager 是每家軟體公司都想要的人.
也許將來 ( 或是現在就有 ? ) 會出現專門支持 Zero-Day Copy 的創投公司也說不定. 平常就養一堆技術高超的資訊人食客, 在 DEMO 展之類看到有價值的外國網站就馬上進行 Zero-Day Copy 工程, 反正現在軟體服務專利幾乎是沒有辦法申請的狀態. 有這種公司也是蠻有趣的, 跟我有點合得來 :p
Functionality versus Capability ? A Case in Java OpenCV
這兩天跟學妹一起在對 Java OpenCV Match Template (以下簡稱 Java OpenCV ) 這個 Tool 作一點修改.
Java OpenCV 其實是一個 Adapter, 把 OpenCV ( 著名的 Computer Vision Library ) 內的 cvMatchTemplate Function ( 用 C++ 寫的 ) 包上 Java 的外衣. 而 cvMatchTemplate 的主要能力就是比對基底影像 ( Source Image ) 與模板影像 ( Template Image ), 找出在基底影像中哪些地方存在著與模板影像相似的影像, 以及該處的位置 ( 在圖片或影像截圖上的 ).
為簡化敘述, 先不論 Java OpenCV 其實是 Adapter 而已, 假設把 Java OpenCV 跟 cvMatchTemplate 包在一起看成一個單一的 Component, 而這個 Component 提供一個 Interface 可以輸入基底影像以及模板影像, 而會回傳一個最佳的比對結果影像物件 ( Java Image Object ), 以及位置. 由於這是此 Component 唯一能夠提供的 Service, 因此就說這是 Java OpenCV 的 Functionality.
但是我們需要的是能夠提供多個比對結果的 Functionality. 例如下面的 Java OpenCV 測試圖, 在四個角落都有幾乎同樣的圓點, 但是 Java OpenCV 只會傳回最相似的一個結果而已. 而我們希望四個結果都可以傳回給我們作選擇.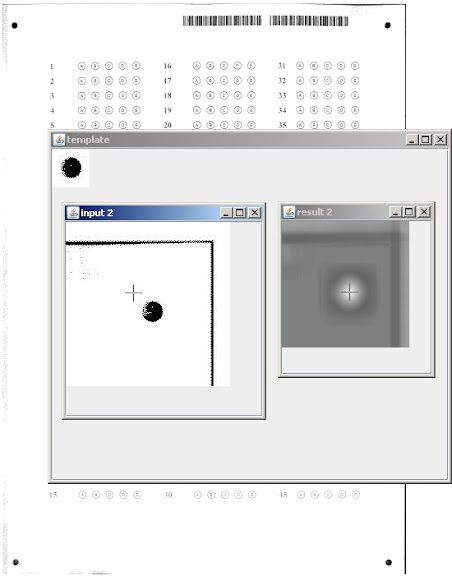
由於短時間內沒有找到其他的 Tool 如此符合我們的需求, 加上 Java OpenCV 的程式碼其實不長, 因此我們去查看了一下原始碼. 在 Java OpenCV 與 cvMatchTemplate之間是使用 JNI 作連結, 而主要的 Image Matching 都是 cvMatchTemplate 進行的沒錯. cvMatchTemplate 是以逐一影像區塊進行比對的方式, 比完整張圖, 因此用了一個很大的 array 來存所有的比對結果.
而 cvMatchTemplate 回傳給 Java OpenCV 的內容其實包含了所有的比對結果, 而不是只有最佳的比對結果. 換句話說, 是在 Java OpenCV 內被做了過濾. 更嚴格來說是在 matchTemplate method 回傳之前, 在 findMaxPoint 裡面被過濾掉了, 只留下最佳的比對結果位置.
這樣一來事情就很簡單了, 我們另外加上了一個 matchTemplateMultiple method, 使用動態決定 Threshold 的方式來過濾出最好的幾個比對結果, 因此可以獲得多個比對結果.
但我覺得有趣的是, 很顯然地 Java OpenCV Component 本身就具有偵測到所有可能比對結果的 Capability, 只是由於他只提供了 matchTemplate 的 Interface, 因此形成了 Functionality 與 Capability 不相稱的情況. 基於 Encapsulation 的原則, 我們不可能從 Interface 就得知 Java OpenCV Component 的真實 Capability, 但是透過知道 Java OpenCV 原本的 Capability, 卻使得我可以評估花較少的 Effort 去增加 Java OpenCV 的 Functionality, 變相地增加了 Java OpenCV 的 Re-usability.
之前會說希望把 Java OpenCV 看成單一 Component 而不要管 Adapter 身份是因為此 Case 有點特殊, Adapter 本身本來就可能對於原本的 Component Functionality 有遮蔽的作用. 但我認為對於一般 Component 來說也可能會有此現象發生, 如果可以有辦法偵測或是表達 Component 本身的 Capability 與 Functionality 之間的差異, 或許會是一件很有用的資訊.
Paper Bad Smell Detection
最近在上柯泰德老師的短期英文編修訓練課程, 邊上就在想一些有的沒的. 最初的三週課程在說明基本的編修原則, 舉很多例子說明. 而其中有很大一部份, 例如精確寫作 (Write for Conciseness) 以及明白寫作 ( Write for Clarity ) 兩大項目中的一些原則, 功用在於不破壞原本要表達的意義下, 讓文句更通順易讀, 同時避免因為一些混淆不清的寫法, 錯誤的時態, 導致讀者誤解了要表達的原意.
這讓我想到 Refactroing. 雖然不是說兩者是一樣的, 但是如果把 Paper 內容當作 Source Code, 的卻有很多相似的地方. 同時柯泰德老師也提到在他的網站上, 蒐集了很多台灣人寫 Paper 常犯的錯誤模式, 建議我們有空可以多看, 並嘗試練習修改, 平日寫 Paper 就比較容易發現不順的地方. 因此很正常地我就想, 如果有一個 Paper Bad Smell Detection Tool 不是很好嗎 ? 邊寫 Paper, 就會自動根據常見的錯誤模式, 提醒我可能要多加修改的地方.
稍微想了一下, 其實只要有一些錯誤模式的 Knowledge 已經存在了, 系統本身似乎也不是那麼難作, 不過準確率可能會是一個問題就是了. 但無論如何, 應該還是比自己看有效率
有這樣的 Tool, 要寫出通順的 Paper 應該會輕鬆一些吧 :)
Lotus Symphony : Web Service + ERC + Document Object ?
只在 ZDnet.com 的新聞稿上看到 IBM 的 Lotus Symphony 介紹文章中有一個有趣的觀點 (不過沒找到原文) :
IBM的主管表示,這項策略不直接與微軟Office競爭,而是把文件當作「容器」(containers),儲存工作流程與協作應用程式內的資訊。在物件導向概念裡, 一個 Object 可以看成是 Data 以及允許改變這些 Data 的 Method 之集合. 在一份文件上, 很顯然地文件裡面用文字或是圖片, 甚至是影音檔案所想要表達的知識是我們需要的 Data. 過去我們可能習慣於直接把文件當作 Data, 但是上述的文字似乎是想把文件當成 Object ? 如果一份文件除了本身所紀錄的 Data 之外, 還紀錄了可以調用哪些 Web Services 來對於文件作存取, 那麼其實可以把整個文件視為一個 Document Object. 此 Document Object 具有 State : 就是 Data, 以及目前執行中的 Web Services, 也具有 Dynamic Behavior, 視乎調用了哪些 Web Services.
這樣一來過往 Document Editor 的角色就更有趣了, 將會變成一個 Web Service Management Tool, 負責結合不同的 Web Services 到 Document Object 上, 每一次的編輯事實上是在不斷的調整Workflow.
在 Lotus Symphony 的網站中也提到了採用 Eclipse Rich Client ( ERC ) 想法, 對於 Lotus Symphony 特別加強 Plug-ins 的支援. 從這點看來 Lotus Symphony 可能是 IBM 在過往 Lotus Smart Suits 的失敗後, 歷經 Eclipse 轉投 Open Source Community 的成功, 以及自身在 Web Service Development & Solution 的領導地位後, 轉而想在 Microsoft Office 以及 Google Docs 兩個極端之間殺出一條不同定位跟發展模式的產品.Users can enjoy the easy-to-use interface and online community for templates, tips and support.
Businesses can control software acquisition and upgrade costs, provide ability to compatibility with Microsoft Office file formats, protect future access to documents with support for ODF and support a global workforce with Lotus Symphony's native language support for over 23 languages.
Developers can extend their applications with the power of Lotus Symphony through support for plug-ins and, when the Lotus Symphony editors inside Lotus Notes are used, rich composite applications.
Software External Behavior under Refactoring ?
在 Martin Fowler 的 Refactoring 書 [1] 中提到 :
Refactoring is the process of changing a software system in such a way that it does not alter the external behavior of the code, yet improves its internal structure.
然而, 究竟 external behavior 如何認定, 甚麼算是 external behavior, 而甚麼又不是呢 ?
也許我們應該從 refactoring 的目的來看. refactoring 的目的是為了整理目前的 code ( 目前探討 refactoring 停留在 code level 居多, 因此沿用 ), 以便以較少的 time & efforts 進行後續的 software changes [2][3] . 因此 refactoring 可以視為是一種 data pre-processing 的技術, 目的在於把 data, 也就是 code, 調整到一個方便進行後續處理的狀況. 而對於後續要進行的處理來說, 其實 refactoring 的步驟並非是必須的, 只是為了降低整體程序的花費而進行 refactoring, 因此自然不希望在進行 refactoring 的過程中, 會改變 code 本身對於原本要進行的 software changes 之意義. 而這些不允許被改變的部份, 就是 external behavior.
換句話說, 在 refactoring 中, external behavior 的認定跟所要進行的 software changes 有關, 而所要進行的 software changes 又跟 software engineers 有關. 最常見的可能是由 test cases 所保證的 external behavior, 這類型的大多跟 software functionality change 比較有關, 也比較容易理解.
但是從另外一個角度來說, refactoring 畢竟還是改變了 code structure, 對於整個 source code 的意義還是造成了些許的改變, 只是這樣的改變對於要進行的 software changes 來說是否需要關心罷了. 比如說 pull-up-method, 改變前後的意義考量到原始的設計還是有差別的. 只是當我們的目的是方便後續的 maintenance 工作時, 這個差別就會被忽略不計.
然而這樣對於 software maintenance 長期來說是好事嗎 ? 或者只是炒短線的作法呢 ? 畢竟在 [2][3] 中似乎都沒有針對往後其他無關原本預計進行的 software changes 作探討. 然而所作的 refactoring 的的確確影響到了之後相關的 maintenance 工作之進行. 我們應該不能僅僅針對所預計進行的 changes 作有效評估才是.
References
[1] M. Fowler, Refactoring: Improving the Design of Existing Programs, Addison-Wesley, 1999.
[2] E. Stroulia and R. Leitch, "Understanding the Economics of Refactoring," In Proceedings of the 5th International Workshop on Economics-Driven Software Engineering Research (EDSER-5): The Search for Value in Engineering Decisions, May 3-4, 2003, Portland, OR, USA, pp. 44-49.
[3] R. Bahsoon and W. Emmerich, "Applying ArchOptions to Value the Payoff of Refactoring," In Proc. of the 6th Int. Workshop on Economics-Driven Software Engineering Research, Edinburgh, Scotland. pp. 66-70. IEE.
不務正業的電動刮鬍刀
今天看到某家電動刮鬍刀公司的廣告, 加上手上正在改一篇 Biosignal database 的 paper, 再加上好歹我也算有在作 context-aware 主題, 忽然想到以後是否會有廠商嘗試在電動刮鬍刀上加上完全無關的 biosignal detection device ?
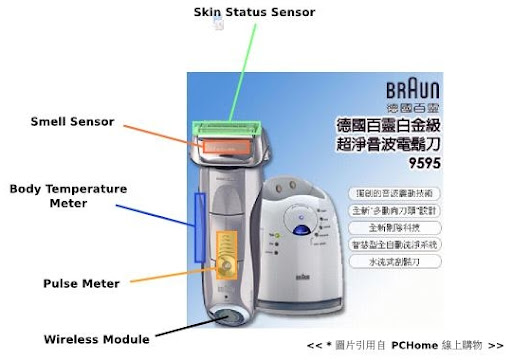
像是這樣 : ( 自 PCHome 購物借用一下德國百靈的商品樣品圖片 )
在括鬍刀片附近, 接觸到下巴臉皮的部份, 可以設置偵測皮膚狀況的 sensor, 在再下方一點可以設置嘴巴氣味的 sensor. 手握的部份, 拇指接觸的部份可以裝設 pulse meter, 側邊可以設置 body temperature meter. 以上這些都跟電動刮鬍刀本身的功能無關, 但是透過電動刮鬍刀本身的 hardware interface, 轉化成為其他 biosignal detection devices 的 interface, 進而把這些 biosignal detection devices "嵌入" ( embed ) 在電動刮鬍刀上.
或許電動刮鬍刀本身不是一個理想的 "母體", 同樣的概念也可以用在其他的日常電氣用品上, 進而讓我們可以在最小的 user interface intrusion 之下, 享受 embedded system 帶來的嶄新服務.
PositLog : 隨意擺放內容的網頁製作系統
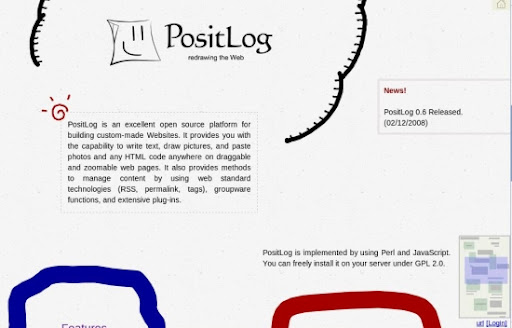
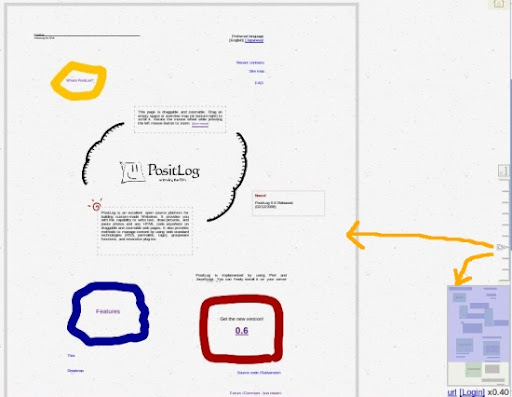
PositLog 有別於一般 CMS 系統的地方在於, 他把所有內容, 可能是文字或是圖片, 或是自己隨手亂畫的東西, 都放在網頁上包成一個一個的物件, 使得你可以任意拖拉放置到任何一個位置. 相對於重視版模設計跟 Widget 安插的其他 CMS 系統, PositLog 更加強調利用對於內容的置放來展現個人的風格.
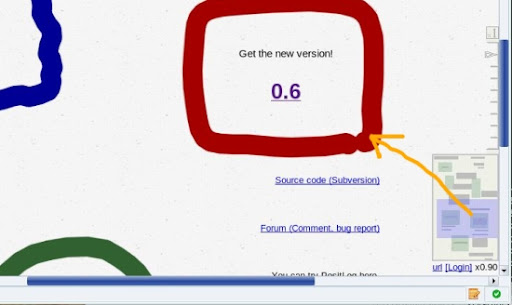
在頁面的右下角, PositLog 提供了一個縮小的 Page Map Overview 以及可以用來調整 Scale 的 ScrollBar, 類似 Google Map 之類的 Ajax 程式也常出現之類的工具.
Page Map Overview 對於 PositLog 來說這是一個必要的設計, 因為在 PositLog 的哲學之下, 個人的網頁內容可能不若一般的網頁來的有閱讀的規則性, 這時候 Page Map Overview 可以讓訪客有一目了然的感覺, 降低整個網頁的複雜感.
ScrollBar 可以用來調整網頁的大小, 這對於希望在瀏覽時動態放大局部的訪客來說應該是很便利的功能.
PositLog 的安裝非常簡單, 下載之後在 document 資料夾內有非常詳細的說明. 在系統需求上, PositLog 只需要
- Web Hosting Server, 例如 Apache.
- Perl 5.8+, 一般的系統應該都很容易安裝, 或是已經有內建了
如果懶得裝想直接試試看, 也可以直接在 PositLog 主網頁右下角找到 SandBox 連結. 目前提供 Rich 模式, Simple 模式, 以及測試中的 Wiki 模式. 以 Rich 模式為例, 可以很容易的選擇任何一個物件進行拖曳 (Drag) 移動以及編輯, 同時上方的 toolbar 也可以用來改變這個物件的一些 attributes.
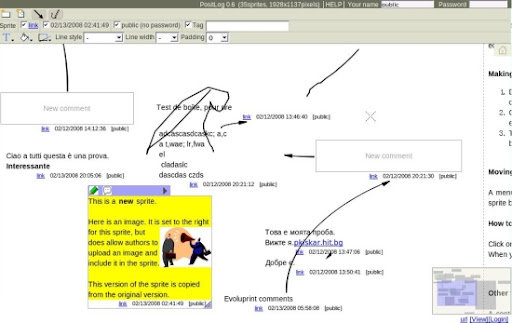
雖然不能說 PositLog 是全新的想法, 而是把過去的兩項很多人想要的 features ( 內容隨意擺置以及簡易放大縮小 ) 結合起來作為主打, 但是的確過去市面上也少見類似的產品. 在這兩項 features 之上, 將有可能發展出許多有趣的應用.
舉例來說, 有許就會有人利用 PositLog 做出一個網頁版的 FreeMind. 利用 FreeMind 製作 MindMap 的缺點在於幾乎只能編寫文字, 同時當整個 MindMap 很大時, 無法快速的看到 Map 全貌, 無法放大縮小 MindMap 等等. 商業化的 MindMap 製作工具對於這些缺點有比較好的改進, 但是仍不夠自由. 試想想如果利用 PositLog 做出網頁版的 MindMap 工具, 對於以上的問題會有比較好的解決, 同時還能夠較為方便地進行多人編輯.
期待在不久的將來就可以看到很多基於 PositLog 衍生出的 OSS 計畫 :)
The Commentator : Personalized Comment Decorator
Cenqua : The Commentator 是一個有趣的想法, 但是看他說明的時候請注意到網頁最下方, 有一行小小的字寫著 : "Promotion running only for April 1".
先假設有這樣的一個 tool 好了, 根據網頁上的文宣, 其實 The Commentator 主打的並非 automatic commentating, 而是 personalized automatic commentating. 在加上 comment 時, 是可以根據你個人的 commentating 習慣, 來產生 "看起來" 是你手動打出的 comments.
換句話說, 其實 The Commentator 是一個 Personalized Comment Decorator, 其前端還需要具有一個 Comment Add-on Suggester 來找出在程式碼的哪個部份會需要加上何種 comments, 形成一個 unified comments, 然後再利用 Personalized Comment Decorator 來對於該 comment 加上潤飾. 而 Personalized Comment Decorator 的潤飾其實是一種 view 的轉換.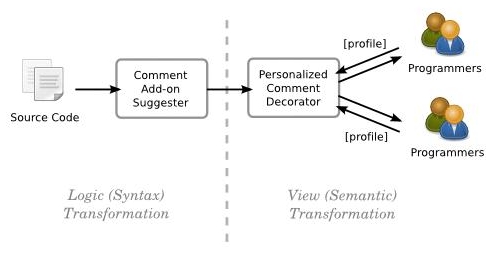
Cenqua : The Commentator 並不全然是不可行的, 甚至在 code generation tool 越來越多, programming phase 正在邁向 fully automation 的同時, 這樣的 commentating tool 或許會變成在 maintenance phase 相當關鍵的產品也說不定.
透過 VirtualBox 的 Application 協同合作 ( VM-based Collaboration )
雖然我的電腦上是裝了雙系統, 分別是 Mandriva 以及 Windows XP, 但是最近切換回 Windows XP 的次數越來越少了. 理由之一是 RMVB 檔在 Compiz-Fusion 開啟下, 使用 Realplayer 不能順利播放的問題, 最近透過改用 SMplayer 解決了. 理由是最近 Microsoft 的 Windows Ginuexxxx ( 忘記怎麼拼 ), 會不斷的跟我說我的 Windows XP 是盜版 ( 明明就是學校買的校園授權版 ), 讓我很不想切換回去.
然後我最近又開始倚賴 VirtualBox 上的 Windows XP 來幫我處理其他在實驗室的必要需求. 像是 :
- 透過 Vigor 網路電視看轉播 : 使用 VirtualBox 完全沒問題, 順得很
- 簡單的編輯排版調整 : 在 VirtualBox 的 Windows XP 內灌好 Office 2003 以及 OpenOffice.org, 當需要把文件寄給 Windows 平台的使用者時, 作個簡單的排版調整就好了.
- 轉換字幕檔 : 有時候需要把非 Unicode 編碼的簡體電影字幕檔轉換成 Unicode 編碼, 這個目前我還找不到 Linux Desktop 下的替代方案, OpenOffice.org 以及其他編輯器開啟非 Unicode 編碼的簡體電影字幕檔往往都會是亂碼, 必須使用 Word 幫忙.
是否針對此類的問題, 我們可以把 VirtualBox 變為一個 Middleware, 來處理兩個 platforms 上的 application softwares 之合作呢 ?
舉 data exchange 來說, VirtualBox 本身會佔用硬碟的一部分空間, 如果把該空間視為 VirtualBox 可以管理的 resources, 然後定義一組 interface 給主系統使用, 另外一組 interface 給 Windows XP 上的 application 使用. 而這兩組 interface 可使用, 透過 VirtualBox 就建立一個 communication channel, 可以 real-time 進行 data exchange, 甚至在 VirtualBox 的幫助下, 可以直接對彼此下 commands.
對於主系統來說, 其實相當於透過 network 與另外一台運作著 Windows XP 的系統進行 communication 並要求 service, 只是透過 VirtualBox, 可以在一台 PC 上直接達成. 甚至當 VirtualBox 同時運作多個系統時, 不同系統上的 applications 之間可以直接進行同樣的 communication.
相對於 Web-based Collaboration, 暫時把這樣的想法稱為 VM-based Collaboration 吧.
Version Controlling Software Diagrams
這幾天同時在忙著跟不同的人合作不同的 project, 剛好都需要建立 design diagrams. 而由於許多前期分析的文件彼此都會修改, 因此早早就用 Subversion 管理這些文件. 而在建立 design diagrams, 忽然想到一個問題 : 怎樣對於 design diagrams 作 version control ?
當然很直覺的, 既然 design diagrams 通常也是一個一個的檔案, 就跟 source code file 一樣管理不就好了 ? 事情當然沒這個單純.
通常一張 design diagram 內包含許多 elements, 例如可能有 10 個以上的 classes, 以及各種 associations. 在 source code level 中, 這些 classes 的 code files 很可能是分開的, 因此不同的 developers 要同時修改不同的 classes 可以很容易的透過 version control 達成. 但是如果今天是在同一張 design diagram 中呢 ? version control 基於本身 data model 的限制, 大概就無法直接幫上忙.
更甚者, 許多 design tools 習慣把一個 project 內的所有 diagrams 包在同一個儲存檔案, 例如 ArgoUML 就用 .zargo 把相關 diagrams 都壓縮在一起. 對於 version control system 來說, 這就只會是一個要管理的檔案, 然而對於使用者 (developer) 來說, 所面對的卻是不同的 diagram 檔案. 在這兩者之間產生了落差.
解決的方法很容易地可以想到幾種, 大多會需要把一張 design diagram 拆開來管理, 例如利用 XMI 來撰寫 design diagram, 然後把 XML elements 拆開來作 version control. 或是在儲存到 version control system 內的時候, 把壓縮起來的檔案解開儲存. 或是乾脆在儲存一張 diagram 時, 就是分開成數個 diagram elements 儲存, 例如 classes 跟 associations.
不過找了找 free / open source design softwares, 好像沒有具備此種 features 的 tools, 是否大家都沒有此種需要呢 ? 但是在 Mandar Chitnis 等人的 UML Tools 文章 [1] 中, 有提到此項 feature, 引用部份內容 :
Version control: A very important feature that we want to have in the UML tool is either an integrated version control mechanism or connectivity to a standard version control system. Configuration management is an integral part in the building of software systems. Considering that the design of a system is a very important artefact of the software lifecycle, maintaining versions and baselines of the system design is a desirable feature to have in UML tools. In the absence of direct support for version control, it is the responsibility of the designer to maintain versions of the design.
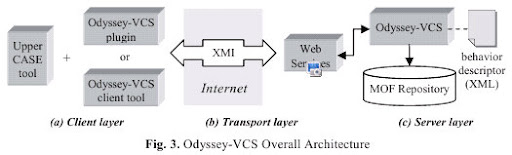
又找了找學術界的部份, 發現有兩篇 papers 討論了這個問題. 第一篇是 H. Oliveira 等人的研究 [2] , 使用 XMI 為儲存基礎. 在 Client 端的 UML IDE tool 以 XMI 輸出 design diagram, 透過 Server 端提供的 web interface 對於 XMI 檔案作必要的處理, 再利用 version control system 儲存. Client 端理論上應該可以使用不同的 UML IDE tools, 但是現實是各家 tools 的 XMI 輸出還是存在 mismatch, 因此很可能還是必須使用同樣的 UML IDE tool.
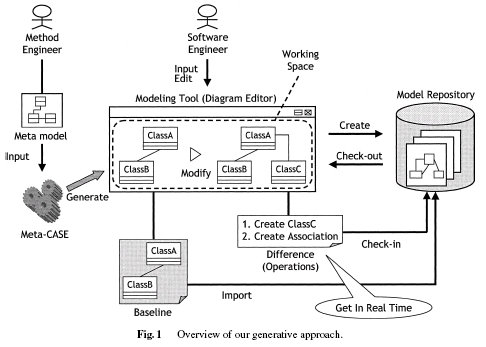
第二篇是 Takafumi Oda 等人的研究 [3], 這篇採用的是不同的作法, 將 software engineer 的編輯動作分解成為單一動作 ( atomic change), 然後編輯時 real-time 記錄下來. 在 check-in 時是紀錄這些動作, 作為 model 改變的代表 ( differences ). 在最初使用時需要 import 一個最初版本的 design diagram ( design model ) 作為 baseline, 而後進行 check-out 時, 是依據這個 baseline 加上中間紀錄的動作, 得到最後的 latest diagram or model ( 或是得到特定版本的 ) . 這個作法的缺點之一是目前的 UML IDE tool 顯然需要作比較多的修改才能配合, 同時如果希望各家 IDE 可以共享 diagram 的話, 還需要制定一個標準給各家公司遵守.
References :
[1] Mandar Chitnis, Pravin Tiwari, & Lakshmi Ananthamurthy, "UML Tools," developer.com, URL : http://www.developer.com/design/article.php/1593811
[2] Hamilton Oliveira, Leonardo Murta, and Cláudia Werner, "Odyssey-VCS: A Alexible Version Control System for UML Model Elements," Proceedings of the 12th International Workshop on Software Configuration Management, pp.1-16, 2005, pdf download here or here (ACM)
[3] Takafumi Oda and Motoshi Saeki, "Meta-Modeling Based Version Control System for Software Diagrams," IEICE Transactions on Information and Systems, vol.4, pp.1390-1402, 2006, pdf download here
Computer Language Benchmarking by Implementation
在 The Computer Language Benchmarks Game ( http://shootout.alioth.debian.org/ ) 網站上提供了由大約 18 個 benchmarks, 由對於大約 34 種 programming languages 的 implementation 作 benchmarking 的結果. 並提供方便的統計或比較觀點查看結果. 他們的計畫網頁可以在 Alioth GForge 找到 : Shootout@Alioth-GForge
例如 Java 6 -server 對 Python 的比較結果 : ( 這兩者在 CPU Time 跟 Memory Usage 上的差異還真是明顯 )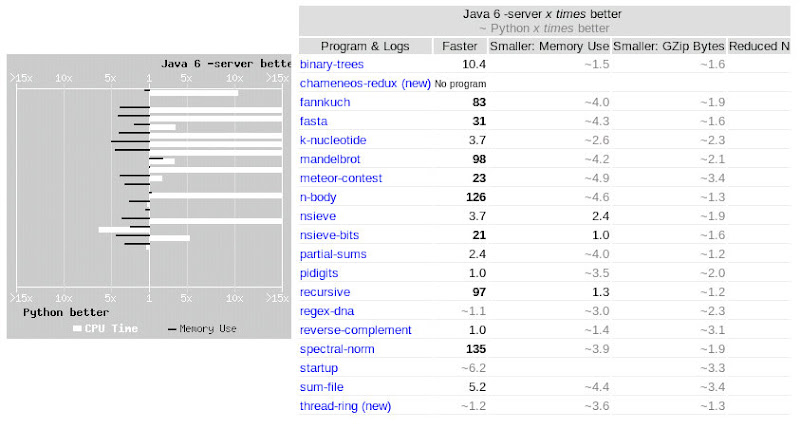
不過當然, 這些 benchmarking 只能反應這些 programming languages 之間比較的小部份面向而已, 就軟體工程的角度而言, 選擇 programming languages 時要考慮的 factors 比這裡所能呈現的多太多了.
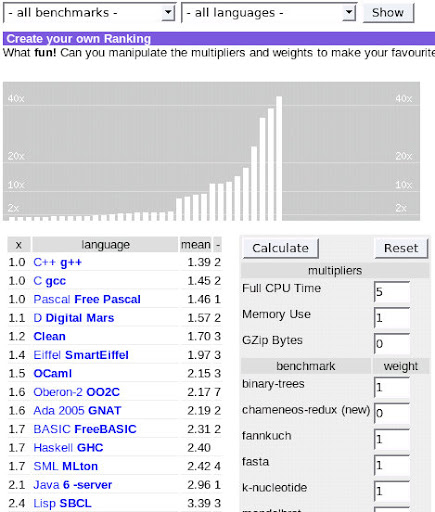
但是從這點出發, 是否未來有一天, 我們也可以靠著在這樣的網頁上, 選取跟目前進行中的 project 相關的 benchmarks, 以及要衡量的 factors, 就決定要利用哪種 programming language 進行開發呢 ? 例如上面的 benchmark 中, 包含了許多基本的 data structure 以及 algorithms 作為 benchmarks, 如果這些 benchmarks 可以組合起來, 提供更為 high-level 的 evaluation benchmark, 同時加上不同的 programming languages 在 architectural components 上得 benchmarks, 那麼我們可能就可以找到更多在軟體工程中可以被利用的 benchmarks, 進而更容易決定 programming languages 的選擇.
EeePC 介面模擬
有人寫了利用單純的 JavaScript + HTML 寫了一個 EeePC 的操作介面模擬網頁, 可以簡單嘗試一下 EeePC 的操作, 不過僅僅是有限的更換工作群組以及模擬程式開啟關閉而已.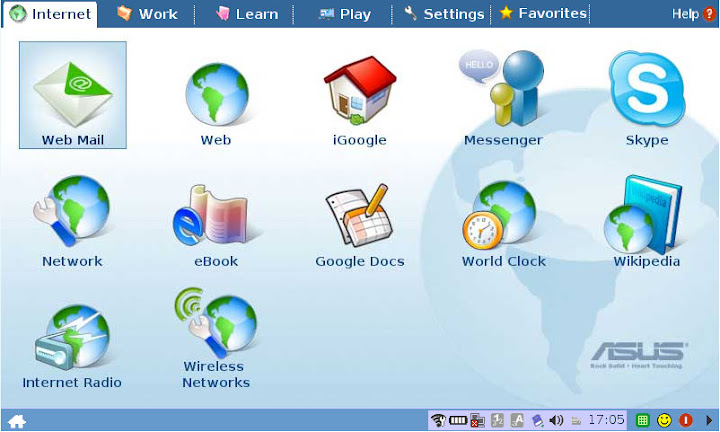
從這點出發, 是否未來我們在建構軟體系統時, 其實有可能以同樣的方式來蒐集使用者對於操作介面的意見, 甚至直接作為廣告宣傳用呢 ? 從上面的 EeePC 介面模擬可以看出來, 其實這樣的 prototyping 在技術上只需要 Image + JavaScript + HTML 就可以完成, 而整個內容則來自於一個或是數個定好的 scenarios. 其他的元件跟操作都是可以在不同的 projects 中進行 reuse 的. 因此撇開需要創建嶄新效果以滿足顧客需求的 software 不談 (例如 Vista), 建立一個這樣的 interface prototyping framework 滿足大部分的 software 需求顯然是可能的.